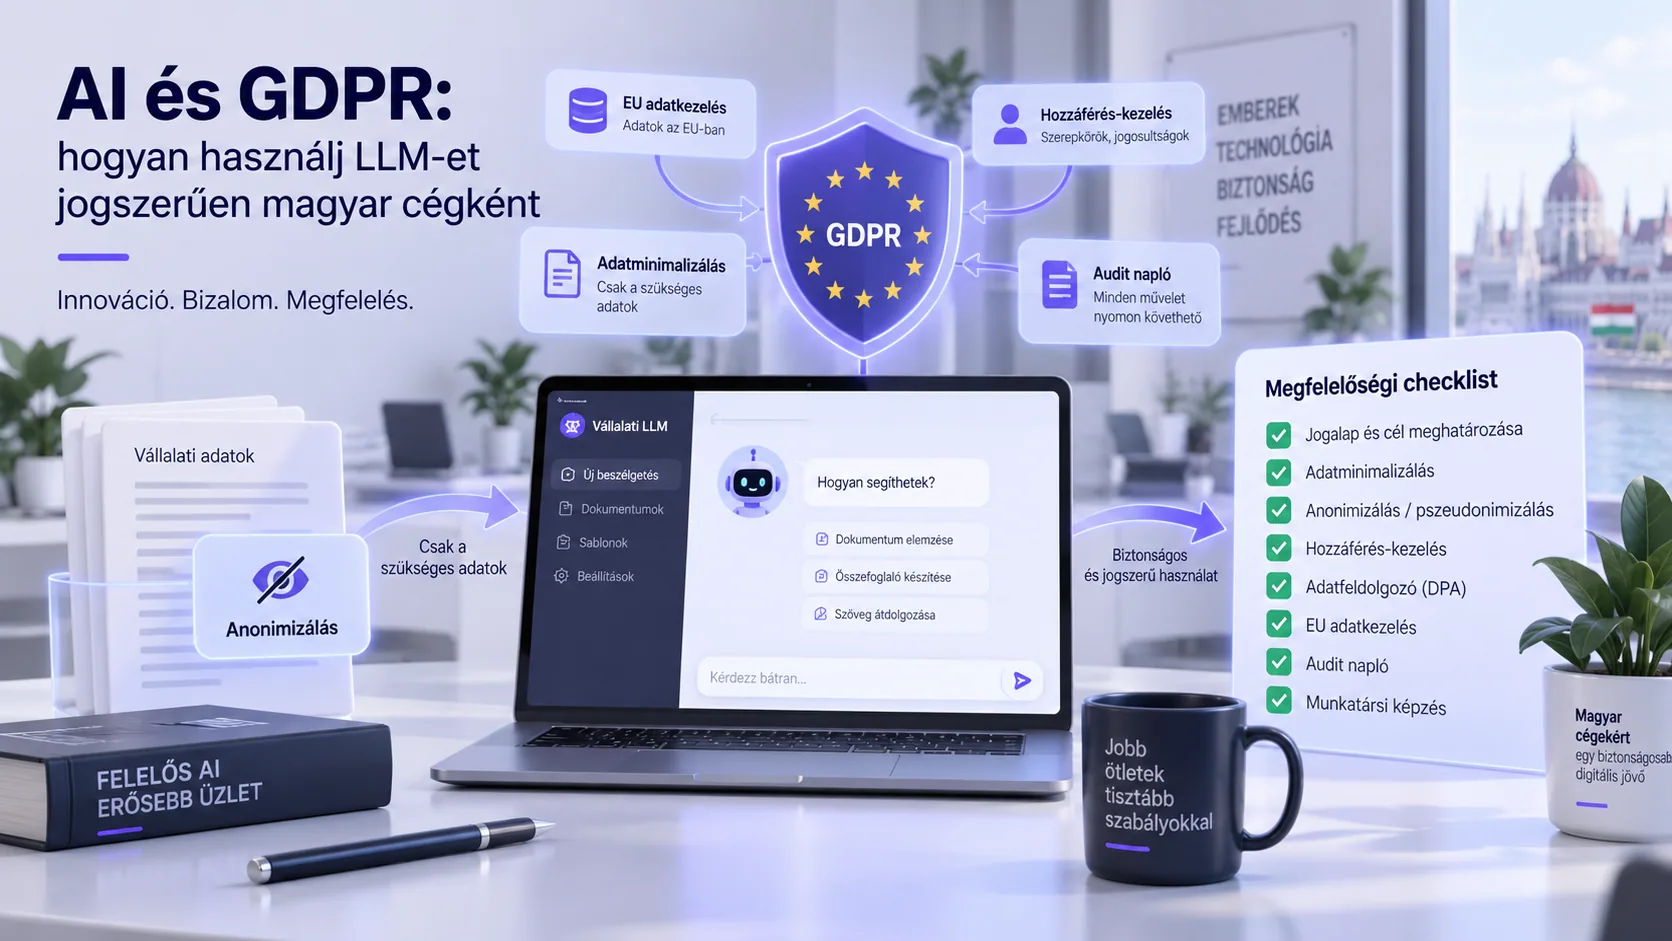
A leggyakoribb GDPR-kérdés, amit LLM-projekt előtt kapunk: „Egyáltalán szabad ügyféladatot AI-nak adni?" A válasz 2026-ban: igen, ugyanolyan feltételekkel, mint bármely más adatfeldolgozónak, csak a feltételek egy részét a legtöbb cég nem tudja, hol keresse. A második leggyakoribb kérdés: „Elég, ha az adatot anonimizáljuk?" Erre a válasz: attól függ, mit értesz anonimizálás alatt, és az esetek többségében, amit annak hívnak, az pszeudonimizálás, ami továbbra is személyes adat.
Ez a cikk a gyakorlati oldalt írja le: milyen jogalapon mehet személyes adat egy LLM-hez, mit kell tartalmaznia az adatfeldolgozói szerződésnek az AI-szolgáltatóval, milyen EU adatrezidencia-lehetőségek vannak a három nagy szolgáltatónál, hogyan néz ki egy pszeudonimizáló pipeline kódban, mi a helyzet a megőrzéssel és a tanításra használattal, hogyan kell érdekmérlegelési tesztet írni, és mit hoz az AI Act. A végén egy checklist, amit a projekt indítása előtt végig lehet menni.
Egy mondat a keretről: ez a cikk mérnöki és folyamat-tapasztalat, nem jogi tanácsadás; a konkrét adatkezelés jogi értékelését a cég adatvédelmi tisztviselője vagy jogásza végzi, és ez a cikk azt a munkát segíti, nem helyettesíti.
A dokumentumfeldolgozás, az ügyfélszolgálati asszisztens és a belső RAG-chatbot a három leggyakoribb eset, ahol a kérdés élesen felmerül; ezek technikai oldalát az AI-alapú dokumentumfeldolgozás és a RAG chatbot építése cikkekben írtuk le. Itt a jogi és a védelmi réteg következik.
Milyen jogalapon mehet személyes adat egy LLM-hez?
Az LLM-használat nem új adatkezelési cél, hanem egy meglévő cél új eszköze. A jogalap ezért a célhoz tartozik, nem a technológiához. Három tipikus eset:
| Használat |
Tipikus jogalap (GDPR 6. cikk) |
Megjegyzés |
| Ügyfél-e-mail kategorizálása, válasz-vázlat |
Szerződés teljesítése (b) vagy jogos érdek (f) |
Az ügyfélkapcsolat kezelése a meglévő cél; az LLM eszköz |
| Szállítói számla kinyerése |
Jogi kötelezettség (c) + jogos érdek (f) |
Számviteli kötelezettség; a kapcsolattartó adata járulékos |
| Belső dokumentumok RAG-chatbotja (munkavállalói adat is) |
Jogos érdek (f) érdekmérlegeléssel |
Munkavállalói adatnál a NAIH gyakorlata szigorúbb |
| Marketing-szegmentálás LLM-mel |
Hozzájárulás (a) vagy jogos érdek (f) |
Profilalkotás esetén 22. cikk és tájékoztatás |
| Önéletrajzok előszűrése |
Jogos érdek (f) + emberi döntés |
Automatizált döntés tilalma (22. cikk) miatt ember dönt |
Ami változik az LLM-mel: új adatfeldolgozó lép be (a modellszolgáltató), esetleg új adattovábbítás történik (EU-n kívülre), és a tájékoztatót frissíteni kell, mert az érintettnek joga van tudni, hogy adatát automatizált eszköz dolgozza fel. A jogalap maga jellemzően nem változik.
Cél
Jogalap
LLM Mint Eszköz
Új Feldolgozó És Továbbítás
Megjegyzés: A „jogos érdek" nem szabad kártya. Érdekmérlegelési tesztet kell hozzá írni (lent), és ha az érintett a saját érdekét erősebbnek tartja, tiltakozhat. Munkavállalói adatnál a NAIH gyakorlata a hozzájárulást nem fogadja el jogalapként az alá-fölérendeltség miatt; ott a jogos érdek és a részletes tájékoztatás a járható út.
Mit tartalmazzon az adatfeldolgozói szerződés az AI-szolgáltatóval?
Az LLM-szolgáltató a GDPR 28. cikke szerinti adatfeldolgozó, ha személyes adatot kap. A szerződést (DPA) nem te írod, a szolgáltató kínálja az üzleti feltételei részeként; a te dolgod, hogy ellenőrizd, benne van-e minden, és elfogadd. 2026-ban mindhárom nagy szolgáltató (Anthropic, OpenAI, Google) üzleti API-feltételei tartalmaznak DPA-t.
Amit ellenőrizni kell:
| Elem |
Kérdés |
Hol keresd |
| Tanítási felhasználás |
Kizárt-e, hogy a promptod és a válasz tanításra menjen? |
„Training", „model improvement" pont a DPA-ban vagy az API-feltételekben |
| Megőrzési idő |
Mennyi ideig őrzi a szolgáltató a promptot? (0-30 nap tipikus, visszaélés-szűrés miatt) |
„Data retention" |
| Alfeldolgozók |
Kik dolgoznak a szolgáltatónak (felhő, támogatás), és értesít-e változásról? |
„Subprocessors" lista |
| Adattovábbítás |
Ha USA-ba megy: EU-USA adatvédelmi keret (DPF) tanúsítás vagy általános szerződési feltételek (SCC) |
„International transfers" |
| Biztonsági intézkedések |
Titkosítás, hozzáférés-kontroll, incidens-bejelentés határideje |
„Security measures", „Breach notification" |
| Audit-jog |
Kérhetsz-e tanúsítványt (SOC 2, ISO 27001) vagy auditot? |
„Audit" |
| Törlés a szerződés végén |
Mi történik az adattal, ha felmondod? |
„Deletion" |
Fontos: a fogyasztói (ingyenes vagy egyéni előfizetéses) chat-felületek feltételei mások, mint az API üzleti feltételei. A fogyasztói felületen a tanításra használat alapértelmezés lehet, és nincs DPA. Céges használatra az API vagy az üzleti csomag való, és a munkavállalókat ki kell oktatni, hogy a saját fiókjukba ne másoljanak ügyféladatot.
Megőrzés és tanításra használat: két külön kérdés
A DPA két pontját gyakran összekeverik.
Megőrzés a szolgáltatónál. A nagy szolgáltatók az API-n beadott promptot és választ visszaélés-szűrés céljából rövid ideig (jellemzően legfeljebb 30 napig) őrzik, azután törlik; egyes üzleti csomagokban nulla napos megőrzés kérhető. Ez az idő a te adatkezelési tájékoztatódban is megjelenik, mint az adatfeldolgozó megőrzési ideje.
Tanításra használat. Az API üzleti feltételei 2026-ban alapértelmezetten kizárják, hogy a beadott adat a modell tanítására menjen. A fogyasztói felületeknél ez nem feltétlenül igaz; ott beállítás vagy opt-out kell. A céges szabály egyszerű: ügyféladat csak API-n vagy üzleti csomagban, ahol a kizárás szerződéses.
Megőrzés nálad. A saját trace-eid (prompt, válasz, kimenet) is személyes adatot tartalmaznak, ha a bemenet azt tartalmazott. A prompt engineering cikkben leírt observability ezért pszeudonimizált vagy hivatkozásos bemenetet naplóz, és a trace-nek is van megőrzési ideje (30-90 nap), amit a nyilvántartásban rögzíteni kell.
Milyen EU adatrezidencia-lehetőségek vannak?
Az adatrezidencia két külön kérdés: hol fut a feldolgozás (melyik régió szervere), és ki fér hozzá (melyik joghatóság alatti cég). Az EU-régiós feldolgozás az elsőt oldja meg; a másodikat a DPA és az adattovábbítási mechanizmus.
| Szolgáltató |
EU-régiós feldolgozás 2026-ban |
Megjegyzés |
| Google (Gemini) |
Vertex AI EU régiókban (pl. europe-west) |
A Gemini fejlesztői API alapból nem régió-kötött; Vertex kell |
| OpenAI (GPT) |
Azure OpenAI Service EU régiókban; OpenAI saját EU-adatrezidencia egyes csomagokban |
Az Azure út a Microsoft DPA-ja alá esik |
| Anthropic (Claude) |
Felhőpartnereken (AWS Bedrock, Google Vertex AI) EU régiókban; közvetlen API-nál a feltételek szerint |
Bedrock esetén az AWS DPA-ja is számít |
A gyakorlati döntés: ha a belső szabályzat, az ügyfélszerződés vagy a szektor (egészségügy, pénzügy, közszféra) EU-n belüli feldolgozást ír elő, akkor a router csak EU-régiós útvonalat engedjen a személyes adatot tartalmazó feladatokra. A modellválasztás cikkben leírt router-minta pont ezt kezeli egy sensitive flaggel.
Ha EU-n kívüli feldolgozás marad (például a közvetlen API bizonyul pontosabbnak az adott feladaton), akkor az adattovábbítás jogalapja kell: a szolgáltató EU-USA adatvédelmi keret szerinti tanúsítása vagy az általános szerződési feltételek (SCC) a DPA-ban, plusz a továbbítás ténye a tájékoztatóban.
Hogyan építs pszeudonimizáló pipeline-t?
A legkevesebb kockázatot az a személyes adat hordozza, ami el sem jut a modellhez. A pszeudonimizálás a beadás előtt cseréli a személyes azonosítókat helyettesítő tokenekre, és a válaszban visszacseréli. A modell így „[SZEMÉLY_1] reklamál a [RENDELÉS_1] miatt" szöveget lát, ami a legtöbb feladathoz elég.
# Pszeudonimizálás LLM-hívás köré (Python, egyszerűsített)
import re
from dataclasses import dataclass, field

@dataclass
class Vault:
    """Token → eredeti érték; a hívás után eldobjuk, soha nem naplózzuk."""
    forward: dict[str, str] = field(default_factory=dict)
    reverse: dict[str, str] = field(default_factory=dict)
    counters: dict[str, int] = field(default_factory=dict)

    def token(self, kind: str, value: str) -> str:
        if value in self.forward:
            return self.forward[value]
        self.counters[kind] = self.counters.get(kind, 0) + 1
        tok = f"[{kind}_{self.counters[kind]}]"
        self.forward[value] = tok
        self.reverse[tok] = value
        return tok

PATTERNS = {
    "EMAIL": re.compile(r"[\w.+-]+@[\w-]+\.[\w.]+"),
    "TEL": re.compile(r"(\+36|06)[ -]?\d{1,2}[ -]?\d{3}[ -]?\d{3,4}"),
    "ADOSZAM": re.compile(r"\b\d{8}-\d-\d{2}\b"),
    "IBAN": re.compile(r"\bHU\d{2}(?: ?\d{4}){6}\b"),
}

def pseudonymize(text: str, vault: Vault, ner) -> str:
    for kind, pat in PATTERNS.items():
        text = pat.sub(lambda m: vault.token(kind, m.group(0)), text)
    # Nevek: mintával nem megy; NER-modell (pl. spaCy hu) vagy címlista alapján
    for name in ner.person_names(text):
        text = text.replace(name, vault.token("SZEMELY", name))
    return text

def rehydrate(text: str, vault: Vault) -> str:
    for tok, value in vault.reverse.items():
        text = text.replace(tok, value)
    return text

def run_safely(input_text: str, prompt: str, llm, ner) -> str:
    vault = Vault()
    masked = pseudonymize(input_text, vault, ner)
    answer = llm.complete(prompt, masked)          # a modell csak tokeneket lát
    result = rehydrate(answer, vault)
    del vault                                       # a kulcs nem éli túl a hívást
    return result
Három megjegyzés a kódhoz:
- A vault a hívással együtt hal meg. Ha elmented (naplóba, adatbázisba), a pszeudonimizálás visszafordítható marad nálad, ami rendben van, de akkor a vault maga is személyes adat, és úgy kell védeni.
- A nevek felismerése a nehéz rész. Regex az e-mailt, telefont, adószámot megtalálja; a „Kovács Péter"-t nem. Magyar NER-modell (spaCy
hu_core_news vagy hasonló) vagy a saját ügyfél-törzsből épített névlista kell, és a fedettséget mérni: 100 valós szövegen hány személyes adat maradt bent.
- Nem minden feladat tűri. Ha a modellnek a névre szüksége van (például megszólítás a válaszban), a token a válaszban visszacserélődik, ez működik. Ha a feladat maga a személyről szól (profilalkotás), a pszeudonimizálás nem old meg semmit; ott a jogalap a kérdés.
PII-felismerés
Token
LLM
Visszacsere
Vault Törlés
Tipp: Az anonimizálás (visszafordíthatatlan) és a pszeudonimizálás (kulccsal visszafordítható) között a GDPR élesen különbséget tesz: az anonim adat kikerül a rendelet hatálya alól, a pszeudonim nem. A fenti pipeline pszeudonimizál, mert a vault visszafordítja. Ez helyes, de a tájékoztatóban ne nevezd anonimizálásnak.
Hogyan írj érdekmérlegelési tesztet LLM-használatra?
Ha a jogalap a jogos érdek, a GDPR (és a NAIH gyakorlata) írásos érdekmérlegelést vár. A teszt három kérdésre válaszol, és egy oldalnál nem kell hosszabbnak lennie:
| Lépés |
Kérdés |
LLM-specifikus szempont |
| 1. Az érdek |
Mi az adatkezelő jogos érdeke? Konkrétan, mérhetően. |
„Ügyfél-e-mailek 4 óra helyett 30 percen belüli megválaszolása"; nem „hatékonyság" |
| 2. Szükségesség |
Elérhető-e a cél kevesebb adattal vagy más eszközzel? |
Pszeudonimizálás bevezetve? Csak a szükséges mezők mennek? Kisebb modell, EU-régió? |
| 3. Mérlegelés |
Az érintett érdekei és ésszerű elvárásai; hatás; garanciák |
Új feldolgozó és esetleges harmadik országba továbbítás; tiltakozási jog biztosítása; emberi felülvizsgálat; tájékoztatás |
A garanciák oszlop az, ahol a technikai intézkedések (pszeudonimizálás, EU-régió, megőrzési idő, hozzáférés-napló) jogi értéket kapnak: minden bevezetett védelem csökkenti az érintettre gyakorolt hatást, és ezzel a mérlegelést az adatkezelő javára billenti. Ezért érdemes a technikai és a jogi munkát együtt csinálni, nem egymás után.
Adatvédelmi hatásvizsgálat (DPIA) akkor kötelező, ha az adatkezelés valószínűsíthetően magas kockázattal jár: nagy léptékű profilalkotás, különleges adat (egészségügyi, biometrikus) vagy rendszeres megfigyelés. Egy számlakinyerő pipeline-nál jellemzően nem, egy ügyfélviselkedést elemző LLM-rendszernél igen.
Mit hoz az AI Act, és mikor?
Az EU AI-rendelet (AI Act) fokozatosan lép hatályba: a tiltott gyakorlatok és az AI-jártassági kötelezettség 2025 februárjától, az általános célú modellekre vonatkozó szabályok 2025 augusztusától, a magas kockázatú rendszerek követelményeinek zöme 2026 augusztusától, egyes ágazati esetek 2027-ig. Egy átlagos magyar KKV-nál a legtöbb LLM-használat (dokumentumfeldolgozás, ügyfélszolgálati asszisztens, belső tudásbázis) nem magas kockázatú, de három dolog rájuk is vonatkozik:
- AI-jártasság (4. cikk). A rendszert használó munkatársak megfelelő szintű ismerete: mit tud, mit nem, mikor kell embernek döntenie. Egy rövid belső képzés és dokumentáció elég, de kell.
- Átláthatóság (50. cikk). Ha egy ember AI-rendszerrel lép kapcsolatba (chatbot), tudnia kell róla. Az ügyfélszolgálati asszisztensnél ez egy mondat a felületen.
- Magas kockázat ellenőrzése. HR (kiválasztás, előléptetés), hitelbírálat, oktatási értékelés, kritikus infrastruktúra: ha az LLM ilyen döntést támogat, a III. melléklet szerinti kötelezettségek (kockázatkezelés, emberi felügyelet, naplózás, dokumentáció) lépnek be. Az önéletrajz-előszűrés a tipikus KKV-s eset, ahol ez felmerül.
Az AI Act és a GDPR párhuzamosan él: az AI Act a rendszer kockázatát szabályozza, a GDPR az adatot. Egy jól dokumentált GDPR-megfelelés (adattérkép, jogalap, garanciák, napló) az AI Act dokumentációs igényének nagy részét is lefedi.
Gyakorlati checklist LLM-projekt indítása előtt
Tizenkét pont, sorrendben. Ha egy pontra „nem" a válasz, ott állj meg, mielőtt élesbe mennél.
- Adattérkép: milyen személyes adat megy a modellhez, kié, honnan, milyen célból.
- Adatminimalizálás: a nem szükséges mezők nem mennek be; pszeudonimizálás ott, ahol a feladat tűri.
- Jogalap célonként, írásban; jogos érdeknél érdekmérlegelési teszt.
- DPA az AI-szolgáltatóval: tanítási kizárás, megőrzés, alfeldolgozók, továbbítás, törlés.
- Csak API vagy üzleti csomag; fogyasztói fiókok tiltása céges adatra, belső szabályzattal.
- Adatrezidencia-döntés: EU-régió, ha a szabályzat, a szektor vagy az ügyfél megköveteli; router a
sensitive feladatokra.
- Adattovábbítás jogalapja, ha EU-n kívüli feldolgozás marad (DPF-tanúsítás vagy SCC).
- Saját megőrzés: trace-ek pszeudonimizálva, megőrzési idővel, hozzáférés-naplóval.
- Tájékoztató frissítése: új feldolgozó, automatizált eszköz, továbbítás, megőrzés, tiltakozási jog.
- Adatkezelési nyilvántartás (30. cikk) frissítése az új feldolgozóval és céllal.
- DPIA-szükséglet vizsgálata; magas kockázatú AI Act-eset kizárása vagy kezelése.
- Emberi felülvizsgálat és AI-jártasság: ki dönt, ki ellenőriz, ki lett kiképezve.
A Rólunk oldalon leírt adatkezelési alapelveink (a megrendelő környezetében dolgozunk, kódot és adatot nem őrzünk meg) ennek a listának a szállítói oldala: a fejlesztőpartner is adatfeldolgozó, és ugyanezek a kérdések rá is vonatkoznak.
Gyakori kérdések
Adhatok ügyféladatot ChatGPT-nek, Claude-nak vagy Geminek?
Igen, ha az API-n vagy üzleti csomagban használod, ahol adatfeldolgozói szerződés van tanítási kizárással, a jogalap a célhoz megvan, és a tájékoztatód említi az új feldolgozót. Fogyasztói fiókon (ingyenes vagy egyéni chat-felület) nem: ott nincs DPA, és a tanításra használat alapértelmezés lehet.
Elég, ha anonimizáljuk az adatot az LLM előtt?
Ha a helyettesítés visszafordítható (kulccsal, vault-tal), az pszeudonimizálás, és az adat személyes marad: a GDPR továbbra is vonatkozik rá, de a kockázat és az érdekmérlegelés jelentősen javul. Valódi anonimizálás (visszafordíthatatlan) kiveszi az adatot a GDPR alól, de a legtöbb üzleti feladatnál nem lehetséges, mert a válaszhoz vissza kell kapcsolni a személyhez.
Kell DPIA egy LLM-alapú ügyfélszolgálati asszisztenshez?
Jellemzően nem, ha az asszisztens válaszvázlatot készít és ember küldi el, nincs profilalkotás, és az adat pszeudonimizálva vagy minimalizálva megy a modellhez. Kell, ha az LLM ügyfélviselkedést elemez, automatizált döntést hoz (például kedvezmény, elutasítás), vagy különleges adatot (egészségügyi) dolgoz fel.
Vonatkozik az AI Act egy magyar KKV LLM-használatára?
Igen, de a legtöbb esetben csak az AI-jártassági és az átláthatósági kötelezettség: a munkatársak képzése és annak jelzése, ha valaki AI-rendszerrel beszél. Magas kockázatú követelmények akkor lépnek be, ha az LLM HR-döntést, hitelbírálatot vagy hasonló, a III. mellékletben felsorolt területen hozott döntést támogat.
Lezárás
Az LLM-használat GDPR-oldala 2026-ban nem tiltás és nem szürke zóna: egy új adatfeldolgozó belépése, esetleg egy adattovábbítás, és a hozzájuk tartozó papírmunka, amit a legtöbb cég a felhős CRM vagy a bérszámfejtő bevezetésénél már egyszer végigcsinált. A különbség a technikai garanciákban van: pszeudonimizálás, EU-régió, megőrzési idő, jogosultság és napló, amelyek a jogi mérlegelést is a cég javára billentik.
A sorrend, amit javaslunk: adattérkép és minimalizálás (egy nap), DPA-ellenőrzés és adatrezidencia-döntés (egy nap), pszeudonimizáló pipeline és trace-szabályok (két-három nap), jogalap, érdekmérlegelés és tájékoztató a DPO-val vagy jogásszal (egy hét átfutás). Ez összesen két hét, párhuzamosan a technikai fejlesztéssel, nem utána.
Az AI Act ehhez képest kevés újat hoz egy tipikus KKV-nál: képzés, átláthatóság, és annak ellenőrzése, hogy a rendszer nem hoz HR- vagy hitelbírálati döntést. Aki a GDPR-oldalt rendben dokumentálta, annak az AI Act-dokumentáció nagy része megvan.
Hivatalos források
- GDPR — a rendelet szövege (EUR-Lex): 6. cikk jogalapok, 28. cikk adatfeldolgozó, 30. cikk nyilvántartás, 35. cikk DPIA
- NAIH — Nemzeti Adatvédelmi és Információszabadság Hatóság: magyar hatósági gyakorlat, állásfoglalások, érdekmérlegelési útmutató
- EDPB — European Data Protection Board: iránymutatások, köztük az AI-modellekre vonatkozó 2024. decemberi vélemény
- AI Act — a rendelet szövege (EUR-Lex): 4. cikk AI-jártasság, 50. cikk átláthatóság, III. melléklet magas kockázat
- Anthropic — Privacy Center: API-adatkezelés, megőrzés, DPA
- OpenAI — Enterprise privacy: API és üzleti csomagok adatkezelése
Kapcsolódó cikkeink: Mobil app GDPR-megfelelés, AI-alapú dokumentumfeldolgozás, Claude vs GPT vs Gemini üzleti használatra.
Ha LLM-projektet indítanátok, és a kérdés az, hogy mi mehet a modellhez és milyen feltételekkel, foglalj egy 30 perces hívást: végignézzük az adattérképet, a szolgáltatói feltételeket és a pszeudonimizálás lehetőségeit, és a DPO-tokkal együtt eldöntjük, mi kell a jogszerű indításhoz. Az AI automatizáció projektjeinkben ez a discovery része, nem utólagos javítás.