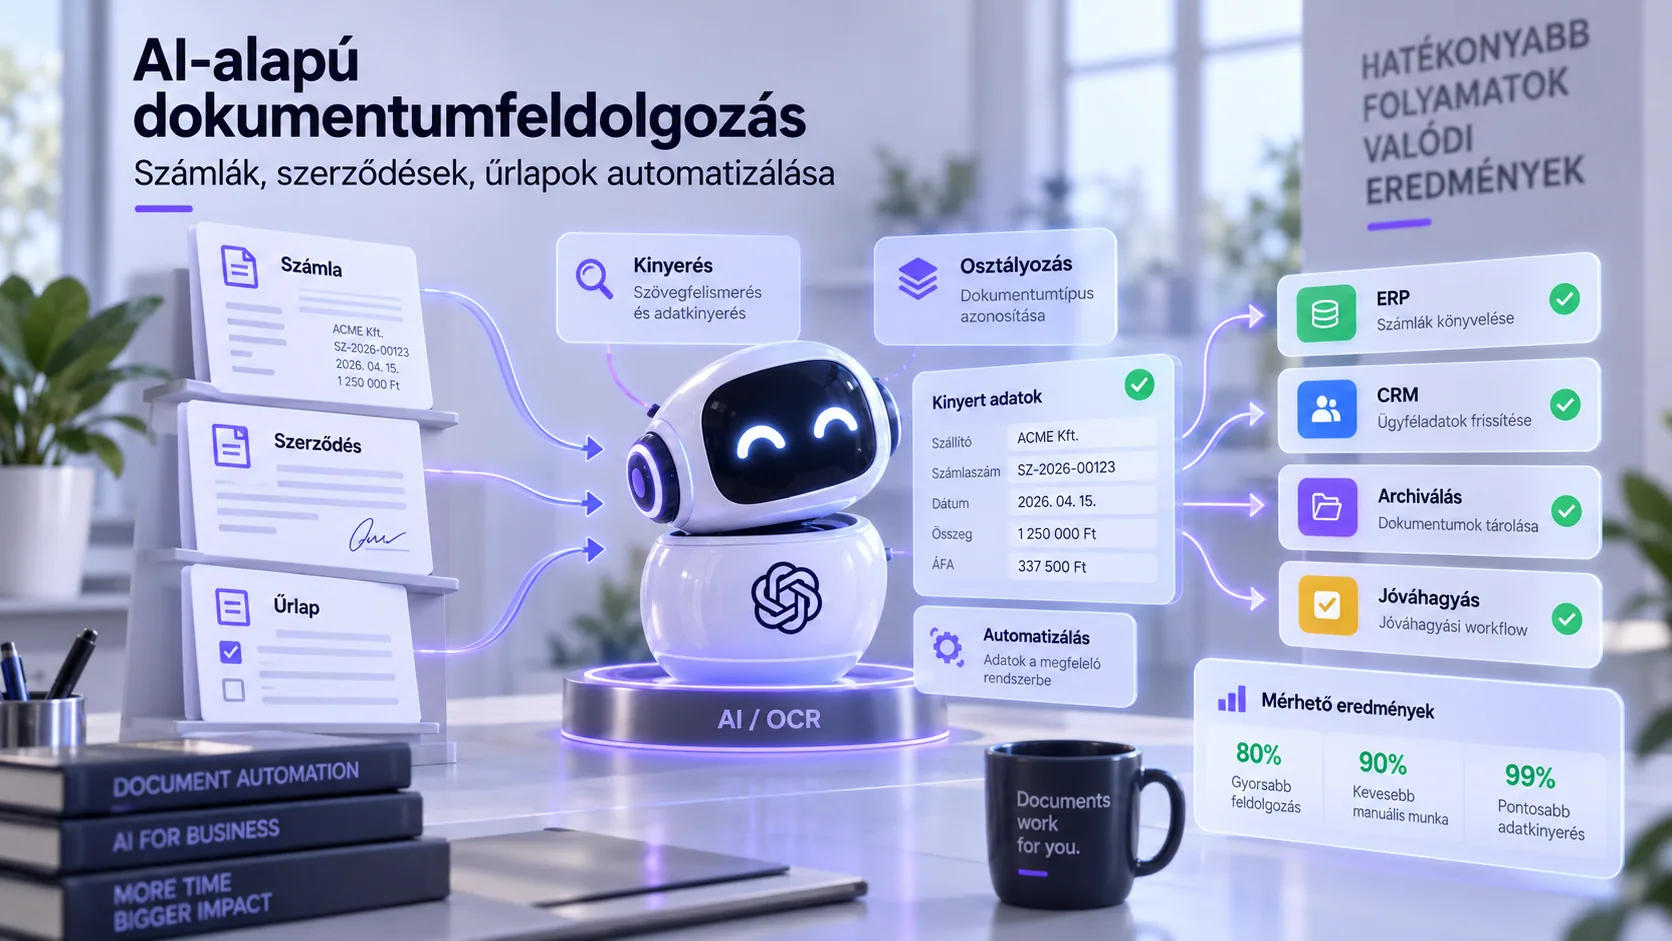
A számla, a szerződés és az űrlap három olyan dokumentumtípus, amelyet minden cég feldolgoz, és amelynél a manuális rögzítés költsége jól mérhető: egy szállítói számla kézi könyvelése 4-8 perc, egy szerződés kulcsadatainak kigyűjtése 15-30 perc, egy ügyfélűrlap átgépelése 3-5 perc. Egy közepes cégnél ez havi 80-200 munkaóra, és a hibák (elgépelt összeg, rossz költséghely, lejárt határidő) költsége ennél is nagyobb.
2026-ban az OCR + LLM kombináció ezt a munkát 70-90%-ban automatizálja, de nem úgy, ahogy a demók mutatják. A demóban egy tiszta PDF-ből egy szép JSON lesz. Élesben 12 szállító 12 formátuma, szkennelt és ferde oldalak, kézzel ráírt megjegyzések, többoldalas tételsorok és olyan mezők, amelyeket a modell magabiztosan rosszul olvas. A különbséget a validáció, a human-in-the-loop és a mérés teszi.
Ez a cikk a teljes pipeline-t írja le a beérkezéstől az ERP-könyvelésig: OCR-választás, JSON-sémás kinyerés, mezőszintű validáció, emberi ellenőrzés csak ott, ahol kell, SAP/ERP integráció, hibaarány-mérés és ROI-számítás. A kódminták Python és TypeScript nyelvűek, a sémák közvetlenül felhasználhatók.
A pipeline nem agent: determinisztikus lépések, egy vagy két LLM-hívással. Hogy mikor indokolt az agent-modell (például szállítói egyeztetésnél), azt az AI ügynökök KKV-knál cikkben írtuk le; itt maradunk a workflow-nál, mert a számlafeldolgozás 95%-ánál ez a jobb választás.
Hogyan épül fel egy OCR + LLM dokumentumfeldolgozó pipeline?
Négy réteg, egymás után, mindegyiknek mérhető kimenettel.
Beérkezés
OCR
LLM Kinyerés
Validáció
HITL
ERP
1. Beérkezés és előfeldolgozás
Forrás: e-mail-melléklet, megosztott mappa, szállítói portál, vagy az ERP saját beérkező sora. Az előfeldolgozás: fájltípus felismerése, többoldalas PDF szétbontása, elforgatás javítása, duplikátum-szűrés (hash + számlaszám). Ez a lépés unalmas és a hibák 10-15%-át itt lehet megelőzni.
2. Szövegkinyerés (OCR vagy natív)
Három eset:
| Bemenet |
Módszer |
Megjegyzés |
| Digitálisan generált PDF |
Natív szövegréteg (pdfplumber, PyMuPDF) |
Pontos, olcsó, layout megtartható |
| Szkennelt PDF / kép |
OCR (Tesseract, felhős OCR, vagy multimodális LLM) |
Minőség a felbontástól függ; 300 dpi alatt romlik |
| Vegyes (PDF ráírással) |
Natív + OCR a képrétegre |
A ráírt megjegyzés gyakran a legfontosabb infó |
2026-ban a multimodális modellek közvetlenül képből is kinyernek, OCR-lépés nélkül. Ez egyszerűbb pipeline, de drágább oldalanként, és a hibák nehezebben lokalizálhatók, mert nincs köztes szöveg, amit ellenőrizni lehetne. Nagy volumenen a klasszikus OCR + szöveges LLM olcsóbb; kis volumenen és bonyolult layoutnál a multimodális út gyorsabban áll fel.
3. LLM-alapú strukturált kinyerés
A modell a szöveget (és a layout-információt) kapja, és egy JSON-sémának megfelelő kimenetet ad. A séma nem opcionális: nélküle a kimenet formátuma hívásonként változik, és a validáció lehetetlen.
4. Validáció, emberi ellenőrzés, könyvelés
A kinyert JSON szabályokon és törzsadat-egyeztetésen megy át; ami nem megy át, emberhez kerül; ami átmegy, az ERP-be. A három lépés aránya a pipeline egészségének mérőszáma.
Hogyan írj JSON-sémát a kinyeréshez?
A séma három dolgot ír le: a mezőket, a típusukat és a bizonytalanság jelzését. Az utolsó a leggyakrabban kihagyott, és a leghasznosabb.
# Számla-kinyerési séma (Pydantic) — a modell tool/structured output bemenete
from pydantic import BaseModel, Field
from typing import Literal
from datetime import date

class LineItem(BaseModel):
    description: str
    quantity: float
    unit: str | None = None
    net_unit_price: float
    vat_rate: Literal[0, 5, 18, 27] | None = Field(
        None, description="Magyar áfakulcs százalékban; None ha nem olvasható."
    )
    net_amount: float

class FieldConfidence(BaseModel):
    field: str
    confidence: float = Field(ge=0, le=1)
    source_page: int | None = None
    note: str | None = Field(None, description="Miért bizonytalan (pl. elmosódott, kézírás).")

class Invoice(BaseModel):
    supplier_name: str
    supplier_tax_id: str | None = Field(None, description="Formátum: 12345678-1-12 vagy HU12345678.")
    invoice_number: str
    issue_date: date
    due_date: date | None
    fulfillment_date: date | None
    currency: Literal["HUF", "EUR", "USD"]
    net_total: float
    vat_total: float
    gross_total: float
    line_items: list[LineItem]
    payment_reference: str | None = None
    confidences: list[FieldConfidence] = Field(
        description="Minden olyan mező, ahol a bizonyosság 0.9 alatt van."
    )
Három elv a sémához:
- Ne kérj olyat, amit nem tudsz ellenőrizni. Az „összeg szavakkal" mező szép, de ha nem validálod, csak zajt ad.
- A
None legyen megengedett. Ha a modellt kényszeríted, hogy mindig adjon értéket, kitalál egyet. A hiányzó érték adat, a kitalált érték hiba.
- Konfidencia mezőnként, ne dokumentumonként. Egy 95%-os dokumentum-konfidencia elrejti, hogy a bruttó összeg 60%-os. A mezőszintű érték dönti el, mi megy emberhez.
A prompt maga rövid: szerep, a séma, két-három szabály (magyar dátumformátum, tizedesvessző, áfakulcsok), és egy-két nehéz példa (few-shot). A prompt engineering vállalati környezetben cikkben leírt sablon-struktúra és verziózás itt egy az egyben alkalmazandó.
Megjegyzés: A séma-kényszerített kimenet (structured output) érvényes JSON-t ad, de nem helyes tartalmat. Egy szintaktikailag hibátlan JSON-ban is lehet felcserélt nettó és bruttó. A validáció a következő réteg, nem opció.
Szerződések: miben más, mint a számla?
A számla rövid, formátuma szállítónként stabil, és a mezők számszerűek. A szerződés 5-60 oldal, egyedi szerkezetű, és amit ki kell nyerni, az részben szöveg (felmondási feltétel, kötbér-klauzula), részben dátum (lejárat, automatikus hosszabbítás határideje), részben pénz (díj, indexálás).
Három dolog változik a pipeline-ban. A kinyerés előtt szakaszolás kell: a modell nem a teljes dokumentumot kapja, hanem a releváns fejezeteket (a tartalomjegyzék vagy egy első, olcsó „melyik oldalon van a felmondás?" lépés alapján), mert a 60 oldal egyben beadva drágább és pontatlanabb. A sémában a szöveges mezők mellé forrás-idézet kerül: a modell a kinyert értékkel együtt visszaadja az eredeti mondatot és az oldalszámot, így a review-felületen az ember egy kattintással ellenőrzi, és nem kell újraolvasnia a szerződést. A validáció pedig nem összegeket egyeztet, hanem következetességet: a lejárati dátum későbbi-e a hatálybalépésnél, a felmondási idő rövidebb-e a futamidőnél, a díj devizája egyezik-e a fizetési feltételekével.
A megtérülés itt nem a rögzítési időből jön, hanem az elkerült határidő-mulasztásból: egy automatikusan hosszabbodó szerződés, amelyet a felmondási ablakban senki nem vett észre, egy éves díjba kerül.
Hogyan validálj, és mikor kell ember a folyamatba?
A validáció három rétege olcsótól drágáig. A cél: a dokumentumok 70-90%-a az első két rétegen átmenjen, és csak a maradék kerüljön emberhez.
1. Szabályalapú ellenőrzés (ingyen, azonnali)
// Mezőszintű validáció (TypeScript) — minden szabály egy hibaüzenetet ad, nem dob
type Issue = { field: string; severity: 'error' | 'warn'; message: string };

export function validateInvoice(inv: Invoice, master: MasterData): Issue[] {
  const issues: Issue[] = [];
  const sumNet = inv.line_items.reduce((s, li) => s + li.net_amount, 0);

  if (Math.abs(sumNet - inv.net_total) > 1) {
    issues.push({ field: 'net_total', severity: 'error', message: 'Tételsor-összeg ≠ nettó végösszeg' });
  }
  if (Math.abs(inv.net_total + inv.vat_total - inv.gross_total) > 1) {
    issues.push({ field: 'gross_total', severity: 'error', message: 'Nettó + áfa ≠ bruttó' });
  }
  if (inv.supplier_tax_id && !isValidHuTaxId(inv.supplier_tax_id)) {
    issues.push({ field: 'supplier_tax_id', severity: 'error', message: 'Adószám ellenőrzőszám hibás' });
  }
  if (inv.due_date && inv.due_date < inv.issue_date) {
    issues.push({ field: 'due_date', severity: 'warn', message: 'Esedékesség a kiállítás előtt' });
  }
  if (!master.suppliers.byTaxId(inv.supplier_tax_id)) {
    issues.push({ field: 'supplier_name', severity: 'warn', message: 'Ismeretlen szállító a törzsadatban' });
  }
  for (const c of inv.confidences) {
    if (c.confidence < 0.8) {
      issues.push({ field: c.field, severity: 'warn', message: `Alacsony konfidencia (${c.confidence})` });
    }
  }
  return issues;
}
Az adószám ellenőrzőszám-számítása, az összegek egyezése, a dátumok sorrendje: ezek a hibák 40-60%-át fogják meg nulla LLM-költséggel.
2. Törzsadat-egyeztetés
Szállító az ERP törzsben, megrendelésszám a nyitott rendelések között, bankszámlaszám egyezik-e a törzzsel (számlacsalás-védelem). Ez a réteg az ERP-ből olvas, ezért az integráció már itt kell, nem csak a könyveléshez.
3. Human-in-the-loop
Ami error szintű hibát kapott, vagy egy kritikus mező konfidenciája a küszöb alatt van, emberhez kerül. A felület lényege: a kinyert mező mellett az eredeti dokumentum kivágása, egy kattintással javítható, és a javítás visszakerül az eval-szetbe.
A HITL-arány az élő mérőszám. Induláskor 30-40%, három hónap után 10-15%, ha a javítások visszafolynak a promptba és az eval-szetbe. Ha nem csökken, a pipeline nem tanul, csak dolgoztat.
Hogyan integráld az ERP-vel vagy az SAP-val?
A kinyert és validált adat az ERP-ben ér valamit. Három integrációs minta, növekvő komplexitással:
| Minta |
Mikor |
Kockázat |
| Fájl-export (CSV/XML) az ERP import-mappájába |
Kis ERP, nincs API |
Nincs visszaigazolás; a hibát az ERP-ben veszik észre |
| REST / OData feladás |
SAP S/4HANA, modern ERP-k |
Jogosultság, idempotencia, hibasor kell |
| Köztes staging-tábla + ERP-oldali feldolgozás |
Nagy volumen, szigorú kontroll |
Két rendszer, két hibalista |
SAP-nál a bejövő számla (Supplier Invoice) OData-szolgáltatáson keresztül adható fel; a tételsorok költséghely- és főkönyvi hozzárendelése vagy a kinyerésből jön (ha a számlán szerepel a megrendelésszám), vagy szabályból (szállító → alapértelmezett költséghely). A logisztikai SAP-integráció esettanulmányunkban ez a minta fut: OData interfész, staging, visszaigazolás.
Két gyakorlati szabály:
- Idempotencia. Ugyanaz a számla kétszer feladva nem könyvelődhet kétszer. A számlaszám + szállítói adószám kulcs a feladás előtt ellenőrizendő.
- Hibasor. Ha az ERP elutasítja (zárt periódus, hiányzó törzsadat), a dokumentum ne vesszen el: külön sorba kerül, emberi kezelésre, a hibaüzenettel.
Az ERP-oldali integráció kérdéseit (jogosultság, transzport, tesztrendszer) a vállalati rendszerek szolgáltatásunknál és az S/4HANA migráció csapdái cikkben vettük végig.
Számla
Validált JSON
SAP OData Feladás
Visszaigazolás
Hogyan mérd a hibaarányt, és mi a jó érték?
A „működik" nem mérőszám. Négy szám, amit az első naptól gyűjtünk:
| Mérőszám |
Definíció |
Cél 3 hónap után |
| Mezőszintű pontosság |
Helyes mező / összes mező, eval-szeten |
≥ 97% kritikus mezőkön (összeg, adószám, számlaszám) |
| Dokumentum-szintű STP |
Emberi érintés nélkül könyvelt / összes |
70-85% |
| HITL-arány |
Emberhez került / összes |
10-20% |
| Átfutási idő |
Beérkezéstől könyvelésig |
< 1 óra automatikus, < 1 nap HITL |
Az eval-szet: 100-200 valós dokumentum, formátumonként arányosan (ha 12 szállító van, mindegyikből legalább 8-10), kézzel ellenőrzött elvárt JSON-nal. Minden prompt- vagy modellváltás után újra fut. A módszertan ugyanaz, mint amit a hallucinációk elleni védekezés cikkben leírtunk, csak itt a mezőszintű egyezés a metrika, nem a szöveg minősége.
Figyelem: A mezőszintű pontosságot formátumonként is nézd. Egy 96%-os átlag elrejtheti, hogy egy szállító számláin 75% a pontosság, mert a modell rendszeresen felcseréli a nettó és a bruttó oszlopot. A formátumonkénti bontás mutatja meg, hova kell few-shot példa.
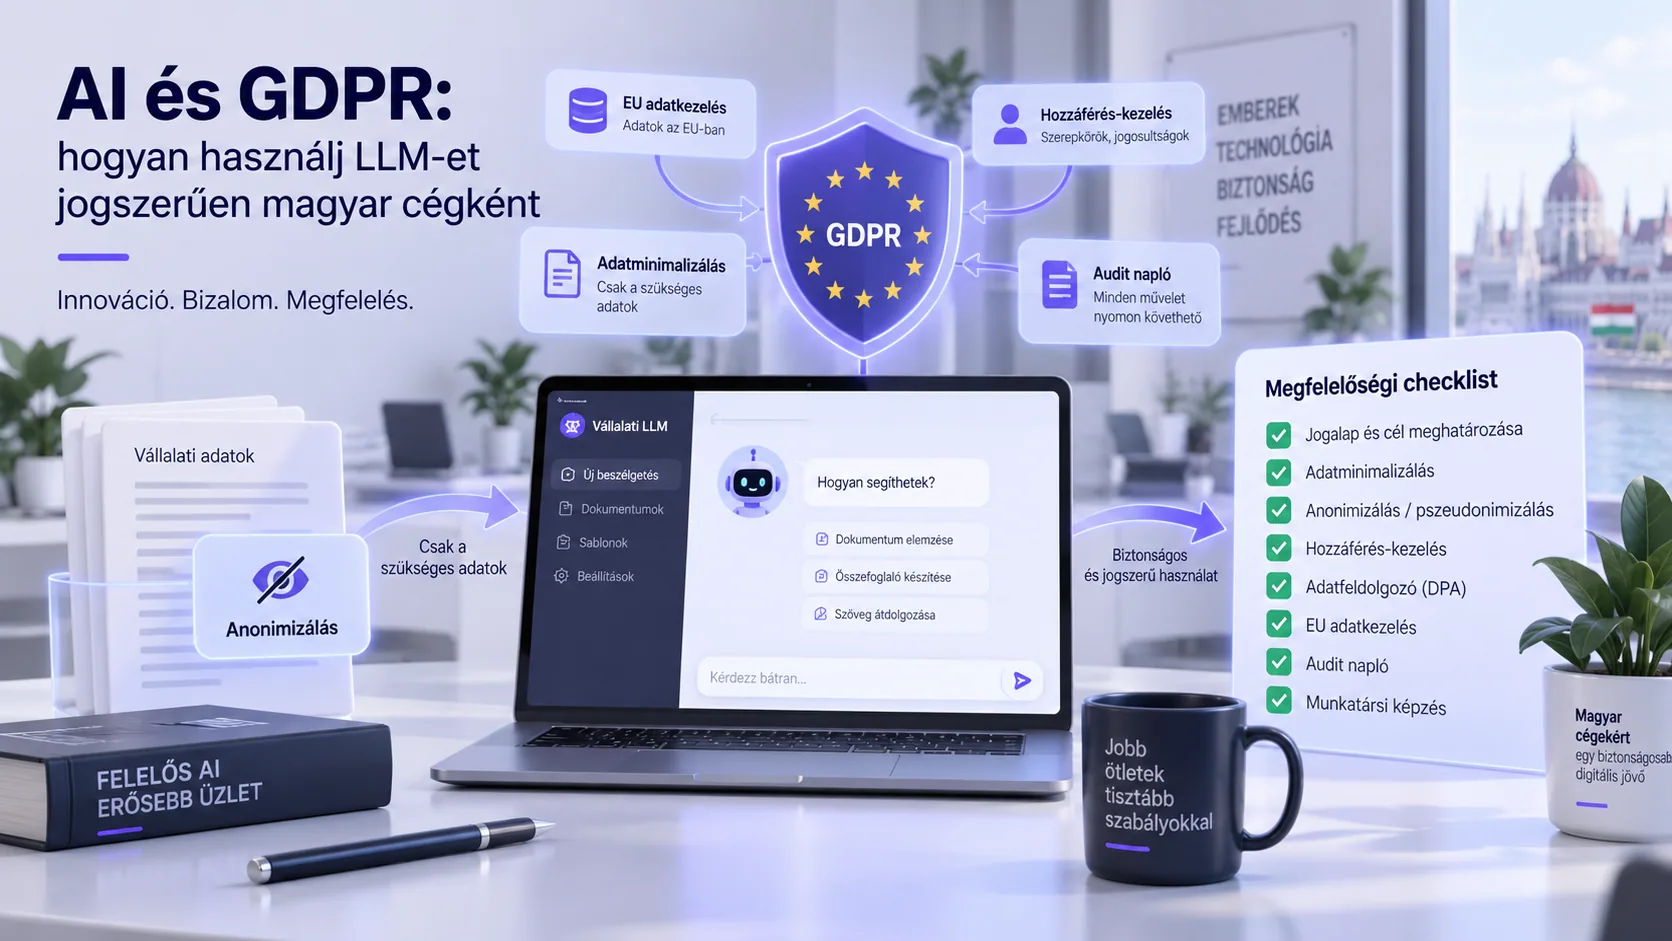
Milyen GDPR-szempontok vannak a dokumentumfeldolgozásnál?
A számlán és a szerződésen személyes adat van: kapcsolattartó neve, e-mailje, aláíró, egyéni vállalkozó adatai. Az LLM-szolgáltató ezért adatfeldolgozó, és a következők kellenek:
- Adatfeldolgozói szerződés (DPA) a szolgáltatóval, tanítási opt-outtal. 2026-ban a nagy szolgáltatók üzleti feltételei ezt tartalmazzák.
- Adatminimalizálás. A modellnek csak az kell, ami a kinyeréshez szükséges. A pipeline a beadás előtt maszkolhatja azt, ami nem kell (például bankszámlaszám, ha a törzsadat-egyeztetés úgyis ERP-oldalon történik).
- Megőrzés. A szolgáltató oldali prompt-megőrzés (0-30 nap a feltételektől függően) szerepeljen az adatkezelési tájékoztatóban.
- EU-régió személyes adatnál, ha a belső szabályzat vagy az ügyfél megköveteli.
A pipeline másik felén: a review-felületen a dokumentumot csak az láthassa, akinek a munkaköréhez tartozik, és a naplózás rögzítse, ki mit javított. A részleteket (jogalap, érdekmérlegelés, pszeudonimizálás) az AI és GDPR magyar cégeknek cikkben vesszük végig.
Mennyit spórol egy dokumentumfeldolgozó rendszer?
Egy konkrét, nagyságrendi számítás egy havi 1 500 szállítói számlát feldolgozó cégre:
Jelenlegi költség:
  1 500 számla × 6 perc = 150 óra / hó
  150 óra × 5 500 Ft (terhelt óradíj, könyvelési asszisztens) = 825 000 Ft / hó
  + hibajavítás, késedelmi kamat, kétszer könyvelt tétel: becsült 100-150 000 Ft / hó

Automatizált pipeline (3. hónap után, 80% STP, 15% HITL, 5% hibasor):
  LLM + OCR költség: 1 500 × ~15 Ft = ~25 000 Ft / hó
  HITL: 225 számla × 2 perc = 7,5 óra × 5 500 Ft = ~41 000 Ft / hó
  Hibasor: 75 számla × 6 perc = 7,5 óra = ~41 000 Ft / hó
  Üzemeltetés, eval-karbantartás, monitoring: 80-120 000 Ft / hó
  Összesen: ~200-230 000 Ft / hó

Megtakarítás: ~700-750 000 Ft / hó (+ a hibaköltség nagy része)

Bevezetés (discovery, pipeline, HITL-felület, SAP-integráció, eval): 3-5 M Ft
Megtérülés: 5-7 hónap
A számítás két tényezőre érzékeny: a volumenre (havi 300 számla alatt a bevezetés ritkán térül meg egy éven belül) és az STP-arányra (ha 3 hónap után is 50% alatt van, a formátumok vagy a séma rossz). Szerződéseknél a képlet más: kevesebb dokumentum, de dokumentumonként 15-30 perc megtakarítás, és a határidő-figyelés (lejárat, felmondási ablak) önmagában elkerült költség.
Gyakori kérdések
Mennyire pontos az AI-alapú számlafeldolgozás?
Jól felépített pipeline-nal (OCR + JSON-sémás kinyerés + szabályalapú validáció) a kritikus mezők pontossága 3 hónap után 97% fölött van, és a számlák 70-85%-a emberi érintés nélkül könyvelődik. A maradék emberhez kerül; a pontosság ott 100%, mert ember ellenőrzi.
Kell OCR, ha multimodális LLM-et használok?
Nem feltétlenül: a multimodális modellek közvetlenül képből kinyernek. Nagy volumenen az OCR + szöveges LLM olcsóbb és a hibák könnyebben lokalizálhatók; kis volumenen és bonyolult layoutnál a multimodális út gyorsabban áll fel. A döntést a saját dokumentumokon mért pontosság és a Ft / oldal költség hozza meg.
Hogyan kerül a kinyert adat az SAP-ba?
SAP S/4HANA-nál OData-szolgáltatáson keresztül (Supplier Invoice API), idempotens feladással és hibasorral; régebbi vagy kisebb ERP-nél staging-tábla vagy fájl-import. Az integráció a projekt 30-40%-a, ezért a discovery-ben az ERP-oldali jogosultság és tesztrendszer az első kérdés.
GDPR-kompatibilis a számlák LLM-mel való feldolgozása?
Igen, ha van adatfeldolgozói szerződés a szolgáltatóval tanítási opt-outtal, a modell csak a kinyeréshez szükséges adatot kapja, a megőrzési idő szerepel a tájékoztatóban, és érzékeny esetben EU-régiós feldolgozást használsz. A review-felületen a hozzáférés munkakörhöz kötött és naplózott.
Lezárás
A dokumentumfeldolgozás 2026-ban az egyik legbiztosabban megtérülő AI-projekt, mert a bemenet strukturálatlan, a kimenet viszont pontosan definiálható, és a manuális költség mérhető. A demó és az éles rendszer között nem a modell a különbség, hanem a séma, a validáció, a HITL-felület és az eval-szet: ezek nélkül a pipeline az első formátumváltásnál elromlik, és senki nem veszi észre.
A gyakorlati sorrend: gyűjts 100-200 valós dokumentumot formátumonként arányosan, írd meg a sémát a None-t megengedve és mezőszintű konfidenciával, építsd meg a szabályalapú validációt az LLM előtt is és után is, és mérd az STP- és HITL-arányt az első naptól. Az ERP-integrációt a discovery-ben tervezd, ne a végén.
Hivatalos források
Kapcsolódó cikkeink: AI ügynökök KKV-knál 2026-ban, Prompt engineering vállalati környezetben, LLM hallucinációk elleni védekezés.
Ha havi több száz számla, szerződés vagy űrlap megy át kézi rögzítésen nálatok, foglalj egy 30 perces hívást: végignézzük a dokumentumtípusokat, az ERP-oldali lehetőségeket és a várható STP-arányt, és megmondjuk, megtérül-e. A pipeline-t az AI automatizáció projektjeinkben a ti környezetetekben építjük, a dokumentumok nem hagyják el a rendszereteket.