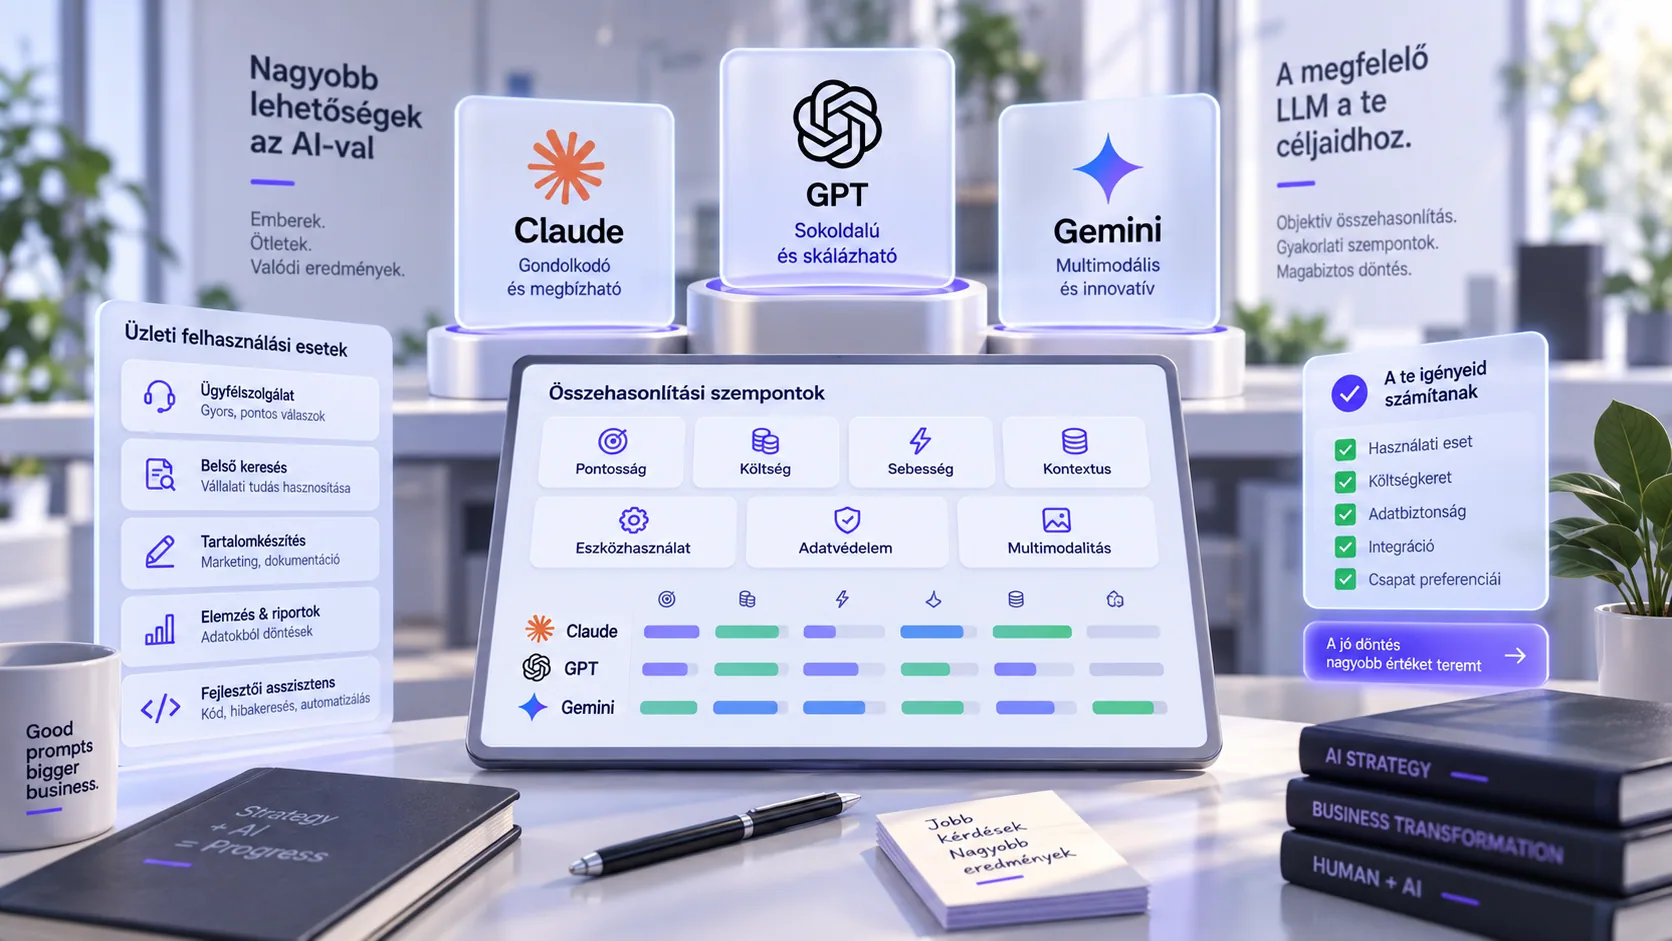
„Melyik modellt válasszuk?" a leggyakoribb kérdés, amit egy AI-projekt első hívásán kapunk, és a legkevésbé hasznos. 2026-ban a három nagy szolgáltató (Anthropic, OpenAI, Google) fő modelljei a legtöbb üzleti feladaton egymástól néhány százalékponton belül teljesítenek a nyilvános benchmarkokon, miközben a te feladatodon a különbség lehet 15-20 százalékpont is, csak épp nem abba az irányba, amit a lista sugall.
Ez a cikk nem rangsor. Egy módszer arra, hogyan válassz modellt egy konkrét üzleti feladatra: hat értékelési szempont, egy összehasonlító tábla a 2026 harmadik negyedéves állapotról, feladattípusonkénti ajánlás, és egy router-minta kóddal, amellyel nem kell egyetlen szolgáltatóhoz kötnöd magad.
Két dolgot előre tisztázunk. Az árak és a képességek gyorsan változnak: minden számot dátummal jelölünk és nagyságrendként kezelünk. A második: a modellválasztás a projekt költségének 5-15%-át befolyásolja; a prompt, az eval-szet és az integráció a többit. Ha ez utóbbiak nincsenek rendben, a modellcsere nem ment meg semmit.
A cikk végén egy checklist áll, amellyel a saját feladatodra tudod lefuttatni az összehasonlítást. A módszer ugyanaz, mint amit az AI implementáció magyar KKV-knál cikkben a use case-választásra írtunk: saját adat, saját mérés, dátumozott döntés.
Milyen szempontok szerint érdemes LLM modellt értékelni?
Hat szempont, amelyeket minden projektnél végignézünk. A sorrend nem fontossági: a feladat dönti el, melyik súlyoz.
1. Kontextusablak és tényleges kihasználhatóság
2026-ban mindhárom szolgáltató kínál 200 ezer tokennél nagyobb kontextusú modellt, a Gemini-vonal 1 millió fölötti ablakkal. A méret azonban nem azonos a használhatósággal: a hosszú kontextus közepén elhelyezett információt a modellek eltérő megbízhatósággal találják meg, és a költség a teljes bemenet után jár. Egy 300 oldalas szerződéscsomag egyben beadva drágább és pontatlanabb, mint a RAG-alapú részleges betöltés.
Ha a modellnek eszközöket kell hívnia (CRM, ERP, keresés), a kérdés nem az, hogy támogatja-e, hanem hogy milyen megbízhatóan választ eszközt és tölti ki a paramétereket. Ezt csak a saját tool-készleteden tudod mérni. Az AI ügynökök KKV-knál cikkben leírt pilot pont ezt méri.
3. Strukturált kimenet
Számlakinyerés, kategorizálás, adatmigráció: a kimenet JSON, nem próza. Mindhárom szolgáltató kínál séma-kényszerített kimenetet (JSON schema vagy hasonló), de az érvényes-JSON arány és a mezőszintű pontosság feladatonként eltér. Ezt méred, nem elhiszed.
4. Latency
Ügyfélszolgálati chatnél a 2 másodperces első token elfogadható, a 8 másodperces nem. Batch-feldolgozásnál a latency lényegtelen, a throughput és a batch-kedvezmény számít. A kis modellek 3-5-ször gyorsabbak, és sok osztályozási feladaton ugyanolyan pontosak.
5. Ár
Az ár 2026 harmadik negyedévében nagyságrendileg: a legkisebb modellek 0,1-0,5 USD / millió bemeneti token, a közepesek 1-3 USD, a legnagyobbak 5-15 USD; a kimeneti token 3-5-ször drágább. A pontos számok negyedévente változnak, a prompt-cache és a batch-API 50-90%-os kedvezményt ad. Ft / feladat szinten számolj, nem token-áron.
6. EU adatkezelés
Melyik régióban fut a feldolgozás, van-e adatfeldolgozói szerződés (DPA), kizárt-e a tanításra használat, mennyi ideig őrzik a promptot. 2026-ban mindhárom szolgáltató kínál üzleti feltételeket tanítási opt-outtal; EU-régiós feldolgozás elérhető a Google (Vertex AI) és a Microsoft (Azure OpenAI) felhőjén, valamint az Anthropic egyes felhőpartnerein. A részleteket az AI és GDPR magyar cégeknek cikkben vesszük végig.
Claude, GPT és Gemini összehasonlítása 2026 Q3-ban
A tábla a három szolgáltató modellcsaládját hasonlítja, nem egy-egy konkrét verziót; mindegyiknél van kis, közepes és nagy modell. Az értékelés a saját projektjeink és eval-szeteink tapasztalata 2026 augusztusáig, nem független benchmark.
| Szempont |
Claude (Anthropic) |
GPT (OpenAI) |
Gemini (Google) |
| Kontextusablak |
200k+ token |
200k-1M token modelltől függően |
1M+ token a fő modelleken |
| Tool use megbízhatóság |
Erős, MCP natív támogatás |
Erős, kiterjedt ökoszisztéma |
Jó, Google-szolgáltatásokkal szoros |
| Strukturált kimenet |
Séma-kényszer, tool-alapú JSON |
JSON schema strict mód |
JSON schema, response_schema |
| Hosszú dokumentum feldolgozás |
Erős pontosság közepes hosszon |
Jó |
Erős nagyon hosszú bemeneten |
| Magyar nyelv |
Jó fogalmazás, ritkább nyelvtani hiba |
Jó |
Jó, esetenként tükörfordítás-jelleg |
| Latency (közepes modell) |
1-3 s első token |
1-3 s |
1-2 s |
| Ár (közepes modell, 2026 Q3) |
1-3 USD / M input |
1-3 USD / M input |
0,5-2 USD / M input |
| EU-régiós feldolgozás |
Felhőpartneren (AWS/GCP EU) |
Azure OpenAI EU régiók |
Vertex AI EU régiók |
| Tanítási opt-out üzleti feltételekkel |
Igen |
Igen |
Igen (Vertex / paid API) |
| Prompt cache / batch kedvezmény |
Igen / igen |
Igen / igen |
Igen / igen |
Amit a tábla nem tud megmondani: hogy a te számláidon, a te ticketjeiden, a te szerződéseiden melyik pontosabb. Erre egyetlen módszer van: 50-100 valós példa, ugyanaz a prompt, mindhárom szolgáltató két-két modellje, egy táblázat pontossággal és Ft / feladat költséggel.
Megjegyzés: A nyilvános benchmarkok (MMLU, HumanEval, SWE-bench és társaik) angol nyelvű, jól definiált feladatokat mérnek. Egy magyar nyelvű, zajos OCR-szövegből kinyerő feladat pontossága ezekből nem következik. A benchmark arra jó, hogy kizárd a nyilvánvalóan gyenge modelleket; a választáshoz kevés.
Melyik modell melyik üzleti feladatra való?
Az alábbi ajánlások a tapasztalatunkból jönnek, és a saját eval-od felülírja őket. A minta viszont stabil: kis modell, ahol a feladat zárt; nagy modell, ahol mérlegelés kell; a közepes a legtöbb helyen elég.
| Feladattípus |
Ajánlott méret |
Mire figyelj |
| Osztályozás, címkézés, routing |
Kis modell |
Latency és ár; a nagy modell itt pazarlás |
| Strukturált kinyerés (számla, űrlap) |
Közepes, séma-kényszerrel |
Mezőszintű pontosság, érvényes JSON arány |
| Hosszú dokumentum összefoglalás |
Közepes vagy nagy, nagy kontextussal |
A közép-kontextus visszakeresési pontosság |
| Ügyfélszolgálati válasz magyarul |
Közepes |
Fogalmazás minősége, hallucináció-arány |
| Agent, több lépéses tool use |
Nagy vagy erős közepes |
Eszközválasztás megbízhatósága, lépésszám |
| Kódgenerálás, refaktor |
Nagy |
Teszt-átmenési arány, nem a demó |
| Batch adattisztítás |
Kis vagy közepes, batch API-n |
Throughput, batch-kedvezmény |
Amikor a nagy modell a rossz választás
Egy napi 5 000 e-mailt kategorizáló pipeline nagy modellel 2026-os árakon havi 150-300 ezer Ft, kis modellel 15-30 ezer Ft, ugyanazzal a pontossággal, ha a kategóriák jól definiáltak. A nagy modell akkor indokolt, ha az eval-szeten mérhetően jobb, és a különbség pénzben többet ér, mint a többletköltség.
Amikor a kis modell a rossz választás
Szerződés-összehasonlítás, ahol a kérdés „mi változott a két verzió között és számít-e", vagy egy 12 lépéses agent, ahol a hibák kumulálódnak: itt a kis modell pontatlansága többe kerül, mint a nagy modell tokenára.
Egy konkrét példa: ügyfélszolgálati pipeline három modellmérettel
Egy webshop napi 800 bejövő üzenetet kap e-mailen és chaten. A pipeline három lépése három különböző modellméretet használ, és ez nem elvi döntés, hanem az eval-szet eredménye.
Az első lépés az osztályozás: rendelés-státusz, visszáru, számla, panasz, egyéb. Kis modell, 40 tokenes kimenet, 0,3 másodperc, 0,2-0,5 Ft üzenetenként. Az eval-szeten a kis modell 96%-ot hozott, a nagy 97%-ot; az egy százalékpont nem éri meg a húszszoros árat.
A második lépés a rendelés-státusz és a visszáru automatikus megválaszolása: közepes modell, tool use a rendelési API-hoz, 200-300 tokenes válasz magyarul. Itt a kis modell 81%-ot hozott (rossz megszólítás, hiányzó lépések), a közepes 93%-ot; a különbség az ügyfélélményben látszik, ezért a közepes nyert.
A harmadik lépés a panaszok: itt nincs automatikus válasz, a nagy modell összefoglalót és javaslatot készít az ügyintézőnek, aki dönt. Napi 60-80 ilyen üzenet, üzenetenként 20-40 Ft, mert a teljes előzményt látnia kell. A napi 800 üzenet teljes LLM-költsége így 2026-os nagyságrendben 3-5 ezer Ft, szemben a 25-40 ezer Ft-tal, ha minden lépés nagy modellen futna.
Hogyan építs multi-model architektúrát?
Egy szolgáltatóra építeni 2026-ban üzleti kockázat: árváltozás, modell-kivezetés, regionális elérhetőség, kimaradás. A multi-model architektúra három elemből áll: absztrakciós réteg, router, fallback.
Absztrakciós réteg
Egyetlen belső interfész (complete(task, input)), amely mögött a szolgáltató-specifikus kliensek élnek. A promptok szolgáltató-független sablonok, a különbségeket (tool-formátum, séma-megadás) az adapter kezeli. Ez teszi lehetővé, hogy a váltás konfiguráció legyen, ne átírás.
Router
A router feladattípus, bemenetméret és érzékenység szerint dönt. Nem „okos" router kell (amely LLM-mel dönt a modellről), hanem szabályalapú: kiszámítható, tesztelhető, olcsó.
// Szabályalapú LLM-router absztrakciós réteggel (TypeScript, egyszerűsített)
type Provider = 'anthropic' | 'openai' | 'google';
type Tier = 'small' | 'medium' | 'large';

type Task = {
  kind: 'classify' | 'extract' | 'summarize' | 'agent' | 'chat';
  inputTokens: number;
  sensitive: boolean; // személyes adat → csak EU-régiós útvonal
};

type Route = { provider: Provider; tier: Tier; region: 'eu' | 'global' };

const EU_ONLY: Provider[] = ['google', 'openai']; // példa: Vertex EU, Azure EU konfiguráció

export function route(task: Task): Route {
  const region = task.sensitive ? 'eu' : 'global';
  const providers = task.sensitive ? EU_ONLY : (['anthropic', 'openai', 'google'] as Provider[]);

  let tier: Tier = 'medium';
  if (task.kind === 'classify') tier = 'small';
  if (task.kind === 'agent') tier = 'large';
  if (task.kind === 'summarize' && task.inputTokens > 150_000) tier = 'large';

  // Elsődleges szolgáltató feladattípus szerint; a sorrend konfiguráció, nem kód.
  const preferred = PREFERENCE[task.kind].filter((p) => providers.includes(p));
  return { provider: preferred[0], tier, region };
}

export async function complete(task: Task, prompt: PromptTemplate, input: unknown) {
  const primary = route(task);
  const candidates = [primary, ...fallbacksFor(primary)];
  for (const r of candidates) {
    try {
      return await adapters[r.provider].complete({ ...r, prompt, input, timeoutMs: 20_000 });
    } catch (err) {
      if (!isRetryable(err)) throw err; // séma-hiba, jogosultság: nem fallback-elünk vakon
      metrics.fallback(r, err);
    }
  }
  throw new Error('all providers failed');
}
A PREFERENCE tábla mondja meg, hogy osztályozásra melyik szolgáltató kis modellje az első, kinyerésre melyik közepes, és így tovább. Ez az eval-szet eredményéből jön, és negyedévente újramérjük.
Fallback
A fallback nem ugyanaz, mint a router: akkor lép be, ha az elsődleges hibázik (timeout, 5xx, rate limit). Két szabály: séma-validációs hibánál nem váltunk vakon másik szolgáltatóra, mert a prompt lehet a hibás; és a fallback-arányt mérjük, mert ha 5% fölé megy, az elsődleges szolgáltatóval van gond.
Feladat
Szabályalapú Router
Szolgáltató-adapter
Fallback
Mennyibe kerül a szolgáltatóváltás?
A váltási költség a leggyakrabban alulbecsült tétel. Nem a kliens-kód átírása a drága, hanem az, ami körülötte van.
| Tétel |
Absztrakciós réteggel |
Anélkül |
| Kliens-kód |
Konfiguráció, 0-1 nap |
2-5 nap |
| Promptok újrahangolása |
2-5 nap (modellenként eltérő stílus) |
5-10 nap |
| Eval-szet újrafuttatás és összevetés |
1-2 nap, ha van eval |
Nincs mihez mérni |
| Tool-sémák és strukturált kimenet |
Adapter kezeli |
Kézzel, minden hívásnál |
| Jogi: új DPA, adatkezelési tájékoztató frissítés |
1-3 hét átfutás |
Ugyanez |
A váltás akkor olcsó, ha az eval-szet és az absztrakció az első naptól megvan. Ha nincs eval, a váltás után nem tudod, jobb vagy rosszabb lett a rendszer; ez a valódi kockázat, nem a kód.
Tipp: Már az első projektben futtasd az eval-szetet két szolgáltatón, akkor is, ha egyet választasz. A második szolgáltató eredménye a fiókban egy kész B-terv: ha az elsőnél ár- vagy feltételváltozás jön, egy nap alatt tudsz dönteni.
Miért nem elég a benchmark a modellválasztáshoz?
Négy ok, amiért a nyilvános rangsor a te feladatodon félrevezethet:
- Nyelv. A benchmarkok túlnyomóan angolok. A magyar nyelvű fogalmazás és a magyar jogi vagy számviteli szókincs pontossága ezekben nem jelenik meg.
- Feladat-eloszlás. A benchmark „átlagos" feladatot mér; a tiéd egy szűk eloszlás (például 12 szállító számlaformátuma). A szűk eloszláson a rangsor felborulhat.
- Prompt-érzékenység. Ugyanaz a prompt modellenként eltérő minőséget ad; a benchmark egy adott prompt-készlettel készült, nem a tiéddel.
- Elavulás. A modellek 3-6 havonta frissülnek; a benchmark-eredmény egy pillanatkép, a saját eval-od bármikor újrafuttatható.
A gyakorlati módszer: a benchmark szűrő (a listából az utolsó harmad kiesik), az eval-szet a döntés. A hallucinációk elleni védekezés cikkben leírt eval-építés itt egy az egyben használható.
Gyakori kérdések
Melyik LLM ad pontosabb magyar nyelvű üzleti szöveget?
2026 harmadik negyedévében mindhárom szolgáltató közepes és nagy modelljei használható magyar szöveget adnak; a különbség feladatonként változik, és a saját eval-szeten 50-100 példával egy nap alatt mérhető. A rangsor helyett a mért pontosságot és a Ft / feladat költséget hasonlítsd össze.
Érdemes egyszerre több LLM-szolgáltatót használni?
Igen, ha van absztrakciós réteg: feladattípus szerinti routing (kis modell osztályozásra, nagy agentre) 3-10-szeres költségkülönbséget hoz, a második szolgáltató pedig fallback kimaradás vagy árváltozás esetén. A többletköltség egy adapter-réteg, ami egy közepes projektben 2-4 nap.
Hogyan használhatok LLM-et úgy, hogy az adat az EU-ban maradjon?
EU-régiós feldolgozás 2026-ban elérhető a Google Vertex AI és a Microsoft Azure OpenAI EU régióin, valamint az Anthropic felhőpartnerein; az üzleti feltételek mindhárom szolgáltatónál tartalmaznak tanítási opt-outot és DPA-t. Személyes adatnál a router csak EU-régiós útvonalat engedjen.
Mennyibe kerül egy LLM-alapú feladat 2026-ban?
Nagyságrendileg: osztályozás kis modellel 0,1-1 Ft / feladat, strukturált kinyerés közepes modellel 5-30 Ft / dokumentum, több lépéses agent-futás 30-500 Ft. A tokenár negyedévente változik; a prompt-cache és a batch-API 50-90%-ot spórol a megfelelő feladatokon.
Lezárás
A modellválasztás 2026-ban nem márkakérdés. A három nagy szolgáltató fő modelljei egymáshoz közel teljesítenek; a te feladatodon mért különbség az egyetlen, ami számít, és azt csak saját eval-szettel tudod megmérni. A hat szempont (kontextus, tool use, strukturált kimenet, latency, ár, EU adatkezelés) feladatonként más súllyal esik latba, ezért nincs egyetlen helyes válasz, csak feladatonként helyes.
Az architektúra fontosabb, mint a választás: absztrakciós réteg, szabályalapú router, mért fallback. Ezzel a modellcsere konfiguráció, nem projekt, és az árváltozás vagy kivezetés nem kockázat, hanem egy napos döntés.
A gyakorlati sorrend: írd le a feladat profilját, gyűjts 50-100 valós példát, futtasd le két-három modellen, tedd egy táblába a pontosságot és a Ft / feladat költséget, és a tábla alapján dönts. Negyedévente futtasd újra.
Hivatalos források
Kapcsolódó cikkeink: AI ügynökök KKV-knál 2026-ban, RAG chatbot építése, AI és GDPR magyar cégeknek.
Ha egy konkrét feladatra kellene modellt választani, vagy a meglévő rendszeretek egy szolgáltatóhoz van kötve és szeretnétek ezt feloldani, foglalj egy 30 perces hívást: végignézzük a feladat-profilt, és megmondjuk, mit érdemes mérni, mielőtt bármit átírnátok. Az AI automatizáció projektjeinkben ez az első hét feladata.