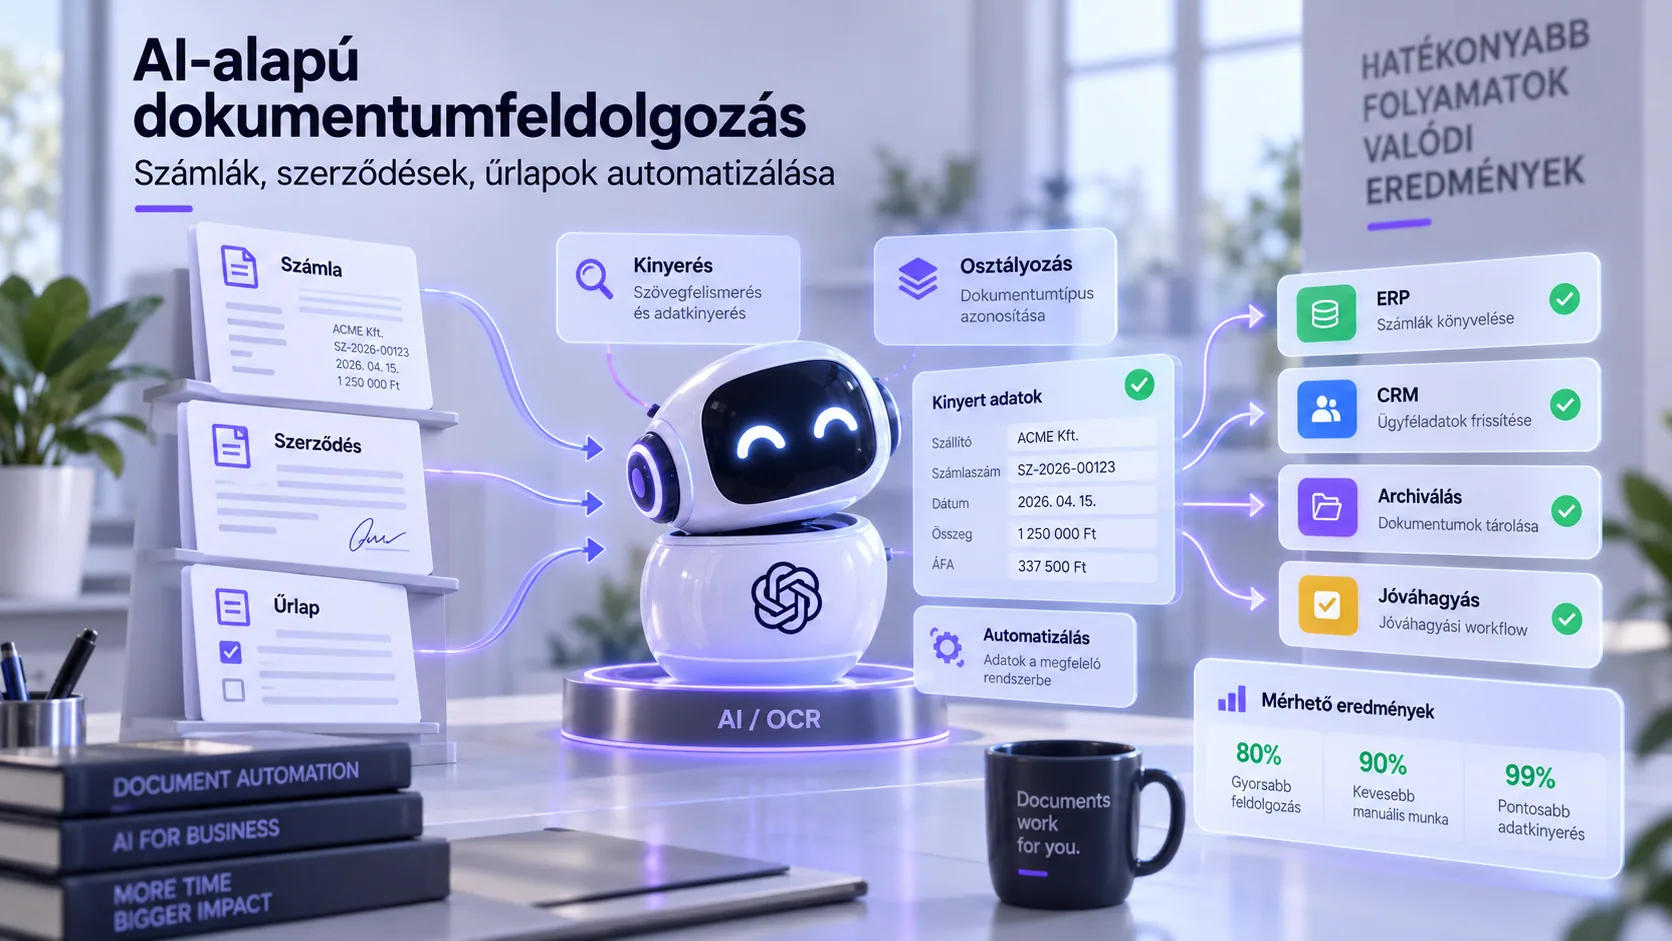
Rechnungen, Verträge und Formulare sind drei Dokumenttypen, die jedes Unternehmen verarbeitet und bei denen sich die Kosten der manuellen Erfassung gut beziffern lassen: Die manuelle Verbuchung einer Lieferantenrechnung dauert 4–8 Minuten, das Herausschreiben der Kerndaten eines Vertrags 15–30 Minuten, das Abtippen eines Kundenformulars 3–5 Minuten. Bei einem mittelgroßen Unternehmen sind das monatlich 80–200 Arbeitsstunden, und die Kosten der Fehler (vertippte Beträge, falsche Kostenstellen, verpasste Fristen) sind noch höher.
Im Jahr 2026 automatisiert die Kombination aus OCR und LLM diese Arbeit zu 70–90 %, allerdings nicht so, wie es die Demos zeigen. In der Demo wird aus einem sauberen PDF ein schönes JSON. Im Produktivbetrieb gibt es 12 Formate von 12 Lieferanten, gescannte und schräge Seiten, handschriftliche Notizen, mehrseitige Positionslisten und Felder, die das Modell selbstbewusst falsch liest. Den Unterschied machen die Validierung, das Human-in-the-Loop und die Messung aus.
Dieser Artikel beschreibt die gesamte Pipeline vom Eingang bis zur ERP-Buchung: OCR-Auswahl, Extraktion nach JSON-Schema, feldbezogene Validierung, menschliche Prüfung nur dort, wo sie nötig ist, SAP-/ERP-Integration, Fehlerquotenmessung und ROI-Berechnung. Die Codebeispiele sind in Python und TypeScript gehalten, die Schemas lassen sich direkt verwenden.
Die Pipeline ist kein Agent: deterministische Schritte mit ein oder zwei LLM-Aufrufen. Wann das Agent-Modell gerechtfertigt ist (zum Beispiel bei der Lieferantenabstimmung), haben wir im Artikel KI-Agenten für KMU beschrieben; hier bleiben wir beim Workflow, weil das bei 95 % der Rechnungsverarbeitung die bessere Wahl ist.
Wie ist eine OCR-plus-LLM-Dokumentenverarbeitungspipeline aufgebaut?
Vier Schichten, nacheinander, jede mit einem messbaren Ergebnis.
Eingang
OCR
LLM-Extraktion
Validierung
HITL
ERP
1. Eingang und Vorverarbeitung
Quelle: E-Mail-Anhang, freigegebener Ordner, Lieferantenportal oder die eigene Eingangswarteschlange des ERP. Die Vorverarbeitung umfasst: Dateityperkennung, Aufteilung mehrseitiger PDFs, Korrektur der Ausrichtung, Duplikatserkennung (Hash + Rechnungsnummer). Dieser Schritt ist unspektakulär, aber hier lassen sich 10–15 % der Fehler von vornherein vermeiden.
Drei Fälle:
| Eingabe |
Methode |
Anmerkung |
| Digital erzeugtes PDF |
Native Textebene (pdfplumber, PyMuPDF) |
Präzise, günstig, Layout bleibt erhalten |
| Gescanntes PDF / Bild |
OCR (Tesseract, Cloud-OCR oder multimodales LLM) |
Qualität hängt von der Auflösung ab; verschlechtert sich unter 300 dpi |
| Gemischt (handschriftlich ergänztes PDF) |
Nativ + OCR für die Bildebene |
Die handschriftliche Notiz ist oft die wichtigste Information |
Im Jahr 2026 extrahieren multimodale Modelle auch direkt aus Bildern, ohne separaten OCR-Schritt. Das ergibt eine einfachere Pipeline, ist aber pro Seite teurer, und Fehler lassen sich schwerer lokalisieren, weil kein Zwischentext zur Kontrolle vorliegt. Bei hohem Volumen ist die klassische Kombination aus OCR und textbasiertem LLM günstiger; bei geringem Volumen und komplexem Layout ist der multimodale Weg schneller einsatzbereit.
Das Modell erhält den Text (und die Layout-Information) und liefert eine Ausgabe, die einem JSON-Schema entspricht. Das Schema ist nicht optional: Ohne es ändert sich das Format der Ausgabe von Aufruf zu Aufruf, und die Validierung wird unmöglich.
4. Validierung, menschliche Prüfung, Buchung
Das extrahierte JSON durchläuft Regeln und einen Stammdatenabgleich; was nicht besteht, geht an einen Menschen; was besteht, geht ins ERP. Das Verhältnis dieser drei Schritte ist die Kennzahl für die Gesundheit der Pipeline.
Das Schema beschreibt drei Dinge: die Felder, ihren Typ und die Kennzeichnung von Unsicherheit. Letztere wird am häufigsten weggelassen – und ist am nützlichsten.
# Rechnungs-Extraktionsschema (Pydantic) — Eingabe für Tool-/Structured-Output des Modells
from pydantic import BaseModel, Field
from typing import Literal
from datetime import date

class LineItem(BaseModel):
    description: str
    quantity: float
    unit: str | None = None
    net_unit_price: float
    vat_rate: Literal[0, 5, 18, 27] | None = Field(
        None, description="Ungarischer Mehrwertsteuersatz in Prozent; None, falls nicht lesbar."
    )
    net_amount: float

class FieldConfidence(BaseModel):
    field: str
    confidence: float = Field(ge=0, le=1)
    source_page: int | None = None
    note: str | None = Field(None, description="Grund der Unsicherheit (z. B. verschwommen, handschriftlich).")

class Invoice(BaseModel):
    supplier_name: str
    supplier_tax_id: str | None = Field(None, description="Format: 12345678-1-12 oder HU12345678.")
    invoice_number: str
    issue_date: date
    due_date: date | None
    fulfillment_date: date | None
    currency: Literal["HUF", "EUR", "USD"]
    net_total: float
    vat_total: float
    gross_total: float
    line_items: list[LineItem]
    payment_reference: str | None = None
    confidences: list[FieldConfidence] = Field(
        description="Alle Felder, bei denen die Konfidenz unter 0.9 liegt."
    )
Drei Grundsätze für das Schema:
- Fragen Sie nichts ab, was Sie nicht prüfen können. Ein Feld „Betrag in Worten" ist hübsch, aber wenn Sie es nicht validieren, erzeugt es nur Rauschen.
None muss zulässig sein. Wenn Sie das Modell zwingen, immer einen Wert zu liefern, erfindet es einen. Der fehlende Wert ist eine Information, der erfundene Wert ist ein Fehler.- Konfidenz pro Feld, nicht pro Dokument. Eine Dokumentkonfidenz von 95 % verschleiert, dass der Bruttobetrag nur bei 60 % liegt. Der feldbezogene Wert entscheidet, was an einen Menschen geht.
Der Prompt selbst ist kurz: Rolle, das Schema, zwei bis drei Regeln (ungarisches Datumsformat, Dezimalkomma, Mehrwertsteuersätze) und ein bis zwei schwierige Beispiele (Few-Shot). Die im Artikel Prompt Engineering im Unternehmensumfeld beschriebene Vorlagenstruktur und Versionierung lässt sich hier eins zu eins anwenden.
Hinweis: Die schema-erzwungene Ausgabe (Structured Output) liefert gültiges JSON, aber nicht zwangsläufig korrekte Inhalte. Auch in einem syntaktisch fehlerfreien JSON können Netto- und Bruttobetrag vertauscht sein. Die Validierung ist die nächste Schicht, keine Option.
Verträge: Was ist anders als bei der Rechnung?
Die Rechnung ist kurz, ihr Format ist je Lieferant stabil, und die Felder sind numerisch. Der Vertrag umfasst 5–60 Seiten, hat eine individuelle Struktur, und was extrahiert werden muss, ist teils Text (Kündigungsbedingung, Vertragsstrafenklausel), teils Datum (Ablauf, Frist für die automatische Verlängerung), teils Geldbetrag (Gebühr, Indexierung).
In der Pipeline ändern sich drei Dinge. Vor der Extraktion ist eine Segmentierung nötig: Das Modell erhält nicht das gesamte Dokument, sondern die relevanten Abschnitte (auf Basis des Inhaltsverzeichnisses oder eines ersten, günstigen Schritts „Auf welcher Seite steht die Kündigung?"), denn 60 Seiten auf einmal einzureichen ist teurer und ungenauer. Im Schema erhalten die Textfelder zusätzlich ein Quellzitat: Das Modell gibt zusammen mit dem extrahierten Wert den Originalsatz und die Seitenzahl zurück, sodass die Person in der Review-Oberfläche mit einem Klick prüfen kann, ohne den Vertrag erneut lesen zu müssen. Die Validierung wiederum gleicht keine Summen ab, sondern die Konsistenz: Liegt das Ablaufdatum nach dem Inkrafttreten, ist die Kündigungsfrist kürzer als die Laufzeit, stimmt die Währung der Gebühr mit der der Zahlungsbedingungen überein.
Der Return on Investment kommt hier nicht aus der Erfassungszeit, sondern aus vermiedenen Fristversäumnissen: Ein sich automatisch verlängernder Vertrag, den im Kündigungsfenster niemand bemerkt hat, kostet eine ganze Jahresgebühr.
Wie validiert man, und wann braucht es einen Menschen im Prozess?
Die drei Schichten der Validierung, vom günstigsten zum teuersten. Das Ziel: 70–90 % der Dokumente sollen die ersten beiden Schichten durchlaufen, und nur der Rest geht an einen Menschen.
1. Regelbasierte Prüfung (kostenlos, sofort)
// Feldbezogene Validierung (TypeScript) — jede Regel liefert eine Fehlermeldung, wirft keine Exception
type Issue = { field: string; severity: 'error' | 'warn'; message: string };

export function validateInvoice(inv: Invoice, master: MasterData): Issue[] {
  const issues: Issue[] = [];
  const sumNet = inv.line_items.reduce((s, li) => s + li.net_amount, 0);

  if (Math.abs(sumNet - inv.net_total) > 1) {
    issues.push({ field: 'net_total', severity: 'error', message: 'Positionssumme ≠ Nettoendbetrag' });
  }
  if (Math.abs(inv.net_total + inv.vat_total - inv.gross_total) > 1) {
    issues.push({ field: 'gross_total', severity: 'error', message: 'Netto + MwSt ≠ Brutto' });
  }
  if (inv.supplier_tax_id && !isValidHuTaxId(inv.supplier_tax_id)) {
    issues.push({ field: 'supplier_tax_id', severity: 'error', message: 'Prüfziffer der Steuernummer ist ungültig' });
  }
  if (inv.due_date && inv.due_date < inv.issue_date) {
    issues.push({ field: 'due_date', severity: 'warn', message: 'Fälligkeit liegt vor dem Ausstellungsdatum' });
  }
  if (!master.suppliers.byTaxId(inv.supplier_tax_id)) {
    issues.push({ field: 'supplier_name', severity: 'warn', message: 'Unbekannter Lieferant in den Stammdaten' });
  }
  for (const c of inv.confidences) {
    if (c.confidence < 0.8) {
      issues.push({ field: c.field, severity: 'warn', message: `Niedrige Konfidenz (${c.confidence})` });
    }
  }
  return issues;
}
Die Berechnung der Prüfziffer der Steuernummer, der Abgleich der Beträge, die Reihenfolge der Daten: Das fängt 40–60 % der Fehler bei null LLM-Kosten ab.
2. Stammdatenabgleich
Ist der Lieferant im ERP-Stamm vorhanden, ist die Bestellnummer unter den offenen Bestellungen, stimmt die Bankkontonummer mit dem Stamm überein (Schutz vor Rechnungsbetrug)? Diese Schicht liest aus dem ERP, daher wird die Integration schon hier benötigt, nicht erst für die Buchung.
3. Human-in-the-Loop
Was einen Fehler der Stufe error erhalten hat oder bei dem die Konfidenz eines kritischen Feldes unter dem Schwellenwert liegt, geht an einen Menschen. Das Wesentliche an der Oberfläche: neben dem extrahierten Feld der Ausschnitt aus dem Originaldokument, mit einem Klick korrigierbar, und die Korrektur fließt zurück in das Eval-Set.
Die HITL-Quote ist die laufende Kennzahl. Beim Start liegt sie bei 30–40 %, nach drei Monaten bei 10–15 %, sofern die Korrekturen in den Prompt und das Eval-Set zurückfließen. Sinkt sie nicht, lernt die Pipeline nicht, sondern lässt nur arbeiten.
Wie integriert man mit dem ERP oder mit SAP?
Die extrahierten und validierten Daten sind erst im ERP wirklich wertvoll. Drei Integrationsmuster mit steigender Komplexität:
| Muster |
Wann |
Risiko |
| Datei-Export (CSV/XML) in den Import-Ordner des ERP |
Kleines ERP, keine API |
Keine Bestätigung; der Fehler wird erst im ERP bemerkt |
| REST-/OData-Übermittlung |
SAP S/4HANA, moderne ERP-Systeme |
Berechtigungen, Idempotenz und Fehlerwarteschlange sind erforderlich |
| Zwischengeschaltete Staging-Tabelle + ERP-seitige Verarbeitung |
Hohes Volumen, strenge Kontrolle |
Zwei Systeme, zwei Fehlerlisten |
Bei SAP kann die Eingangsrechnung (Supplier Invoice) über den OData-Dienst übermittelt werden; die Zuordnung von Kostenstelle und Hauptbuchkonto zu den Positionen kommt entweder aus der Extraktion (wenn die Bestellnummer auf der Rechnung steht) oder aus einer Regel (Lieferant → Standardkostenstelle). In unserer Fallstudie zur SAP-Integration in der Logistik läuft genau dieses Muster: OData-Schnittstelle, Staging, Bestätigung.
Zwei praktische Regeln:
- Idempotenz. Dieselbe Rechnung darf, zweimal übermittelt, nicht zweimal gebucht werden. Der Schlüssel aus Rechnungsnummer und Lieferanten-Steuernummer ist vor der Übermittlung zu prüfen.
- Fehlerwarteschlange. Lehnt das ERP ab (gesperrte Periode, fehlende Stammdaten), darf das Dokument nicht verloren gehen: Es kommt mit der Fehlermeldung in eine separate Warteschlange zur manuellen Bearbeitung.
Die Fragen der ERP-seitigen Integration (Berechtigungen, Transport, Testsystem) haben wir bei unserer Leistung Unternehmenssysteme und im Artikel Häufige Fallstricke der S/4HANA-Migration behandelt.
Rechnung
Validiertes JSON
SAP-OData-Übermittlung
Bestätigung
Wie misst man die Fehlerquote, und was ist ein guter Wert?
„Funktioniert" ist keine Kennzahl. Vier Zahlen, die wir vom ersten Tag an erfassen:
| Kennzahl |
Definition |
Ziel nach 3 Monaten |
| Feldbezogene Genauigkeit |
Korrekte Felder / alle Felder im Eval-Set |
≥ 97 % bei kritischen Feldern (Betrag, Steuernummer, Rechnungsnummer) |
| Dokumentbezogene STP-Quote |
Ohne menschliches Zutun gebucht / gesamt |
70–85 % |
| HITL-Quote |
An Menschen weitergeleitet / gesamt |
10–20 % |
| Durchlaufzeit |
Von Eingang bis Buchung |
< 1 Stunde automatisch, < 1 Tag bei HITL |
Das Eval-Set: 100–200 reale Dokumente, proportional nach Format (bei 12 Lieferanten mindestens 8–10 von jedem), mit manuell geprüftem erwartetem JSON. Es läuft nach jeder Prompt- oder Modelländerung erneut. Die Methodik ist dieselbe wie im Artikel Schutz vor LLM-Halluzinationen beschrieben, nur ist hier die feldbezogene Übereinstimmung die Metrik, nicht die Textqualität.
Achtung: Betrachten Sie die feldbezogene Genauigkeit auch nach Format. Ein Durchschnitt von 96 % kann verbergen, dass die Genauigkeit bei den Rechnungen eines Lieferanten nur 75 % beträgt, weil das Modell regelmäßig die Netto- und die Bruttospalte vertauscht. Die Aufschlüsselung nach Format zeigt, wo ein Few-Shot-Beispiel nötig ist.
Welche DSGVO-Aspekte gibt es bei der Dokumentenverarbeitung?
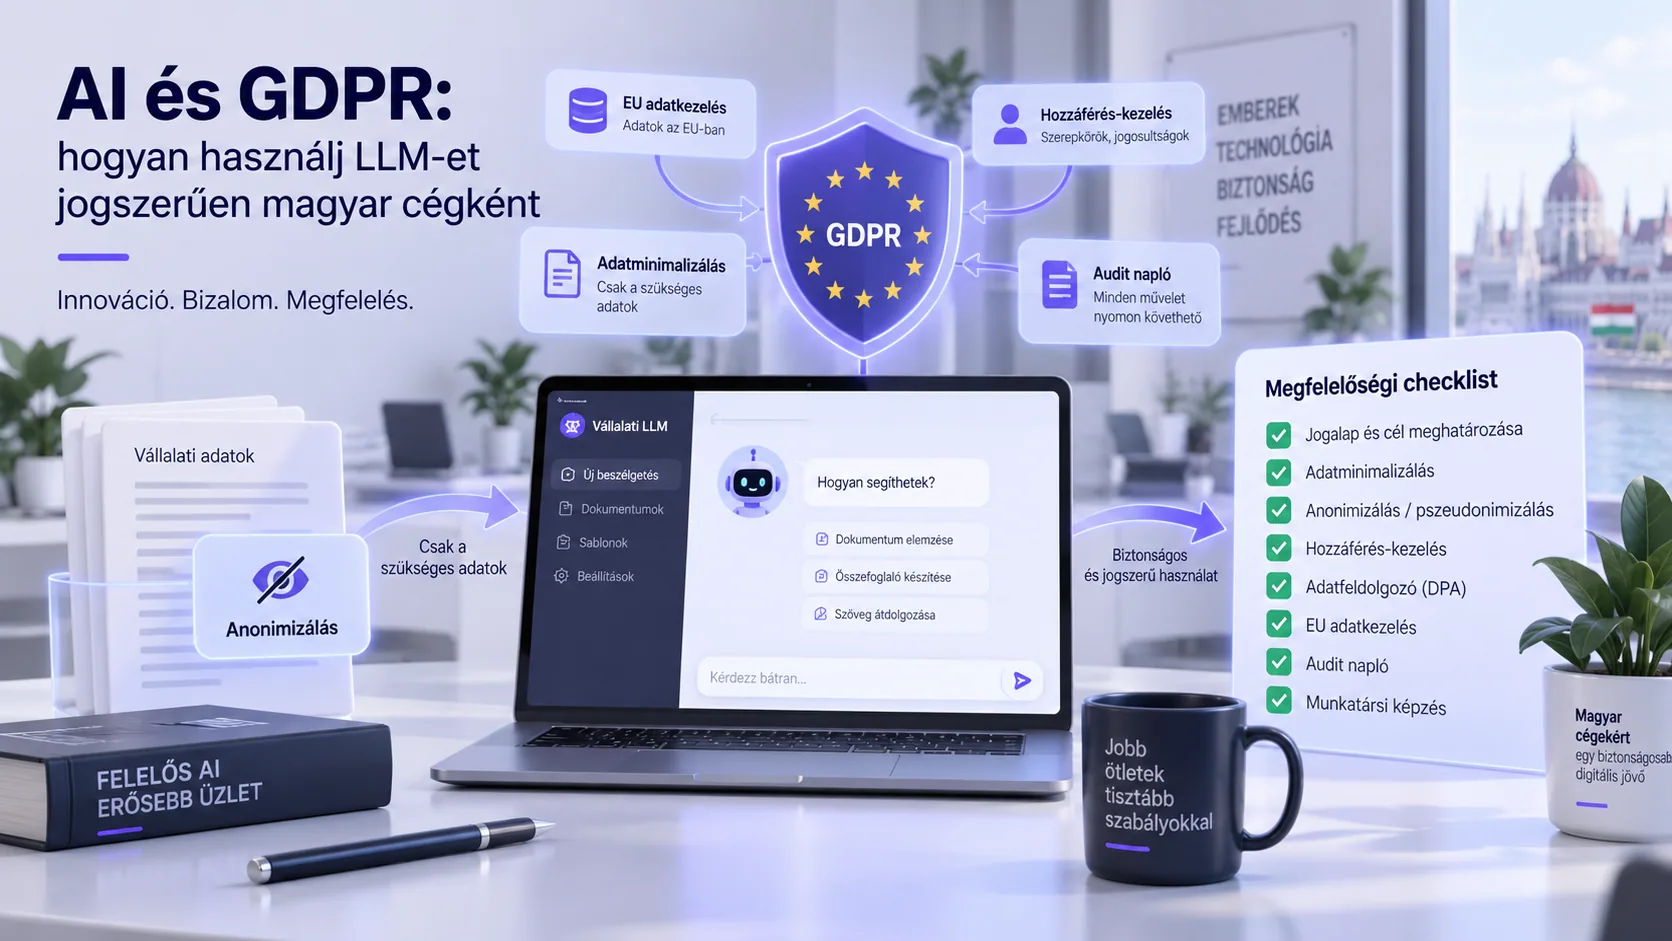
Auf der Rechnung und im Vertrag stehen personenbezogene Daten: Name und E-Mail-Adresse des Ansprechpartners, Unterzeichner, Daten von Einzelunternehmern. Der LLM-Anbieter ist daher Auftragsverarbeiter, und Folgendes wird benötigt:
- Auftragsverarbeitungsvertrag (AVV/DPA) mit dem Anbieter, mit Opt-out vom Training. 2026 enthalten die Geschäftsbedingungen der großen Anbieter dies bereits.
- Datenminimierung. Das Modell braucht nur, was für die Extraktion notwendig ist. Die Pipeline kann vor der Einreichung maskieren, was nicht benötigt wird (zum Beispiel die Bankkontonummer, wenn der Stammdatenabgleich ohnehin ERP-seitig erfolgt).
- Aufbewahrung. Die anbieterseitige Prompt-Aufbewahrung (0–30 Tage, je nach Bedingungen) muss in der Datenschutzerklärung angegeben sein.
- EU-Region für personenbezogene Daten, sofern die interne Richtlinie oder der Kunde dies verlangt.
Auf der anderen Seite der Pipeline: In der Review-Oberfläche darf das Dokument nur einsehen, wer es aufgrund seiner Aufgabe benötigt, und die Protokollierung muss festhalten, wer was korrigiert hat. Die Details (Rechtsgrundlage, Interessenabwägung, Pseudonymisierung) behandeln wir im Artikel KI und DSGVO für ungarische Unternehmen.
Wie viel spart ein Dokumentenverarbeitungssystem?
Eine konkrete Beispielrechnung für ein Unternehmen, das monatlich 1.500 Lieferantenrechnungen verarbeitet:
Aktuelle Kosten:
  1.500 Rechnungen × 6 Minuten = 150 Stunden / Monat
  150 Stunden × 5.500 HUF (Vollkosten-Stundensatz, Buchhaltungsassistenz) = 825.000 HUF / Monat
  + Fehlerkorrektur, Verzugszinsen, doppelt gebuchte Posten: geschätzt 100.000–150.000 HUF / Monat

Automatisierte Pipeline (nach dem 3. Monat, 80 % STP, 15 % HITL, 5 % Fehlerwarteschlange):
  LLM- + OCR-Kosten: 1.500 × ca. 15 HUF = ca. 25.000 HUF / Monat
  HITL: 225 Rechnungen × 2 Minuten = 7,5 Stunden × 5.500 HUF = ca. 41.000 HUF / Monat
  Fehlerwarteschlange: 75 Rechnungen × 6 Minuten = 7,5 Stunden = ca. 41.000 HUF / Monat
  Betrieb, Eval-Pflege, Monitoring: 80.000–120.000 HUF / Monat
  Summe: ca. 200.000–230.000 HUF / Monat

Ersparnis: ca. 700.000–750.000 HUF / Monat (+ der Großteil der Fehlerkosten)

Einführung (Discovery, Pipeline, HITL-Oberfläche, SAP-Integration, Eval): 3–5 Mio. HUF
Amortisation: 5–7 Monate
Die Berechnung reagiert empfindlich auf zwei Faktoren: das Volumen (unter 300 Rechnungen pro Monat amortisiert sich die Einführung selten innerhalb eines Jahres) und die STP-Quote (liegt sie auch nach 3 Monaten unter 50 %, stimmt etwas mit den Formaten oder dem Schema nicht). Bei Verträgen sieht die Rechnung anders aus: weniger Dokumente, aber 15–30 Minuten Ersparnis pro Dokument, und die Fristenüberwachung (Ablauf, Kündigungsfenster) ist für sich genommen bereits eine vermiedene Kostenposition.
Häufig gestellte Fragen
Wie genau ist die KI-basierte Rechnungsverarbeitung?
Bei einer gut aufgebauten Pipeline (OCR + Extraktion nach JSON-Schema + regelbasierte Validierung) liegt die Genauigkeit der kritischen Felder nach 3 Monaten über 97 %, und 70–85 % der Rechnungen werden ohne menschliches Zutun gebucht. Der Rest geht an einen Menschen; dort liegt die Genauigkeit bei 100 %, weil ein Mensch prüft.
Braucht man OCR, wenn man ein multimodales LLM verwendet?
Nicht zwingend: Multimodale Modelle extrahieren direkt aus Bildern. Bei hohem Volumen ist OCR plus textbasiertes LLM günstiger, und Fehler lassen sich leichter lokalisieren; bei geringem Volumen und komplexem Layout ist der multimodale Weg schneller einsatzbereit. Die Entscheidung fällt anhand der an den eigenen Dokumenten gemessenen Genauigkeit und der Kosten in HUF pro Seite.
Bei SAP S/4HANA über den OData-Dienst (Supplier Invoice API), mit idempotenter Übermittlung und Fehlerwarteschlange; bei älteren oder kleineren ERP-Systemen über eine Staging-Tabelle oder einen Datei-Import. Die Integration macht 30–40 % des Projekts aus, weshalb ERP-seitige Berechtigungen und das Testsystem in der Discovery-Phase die erste Frage sind.
Ja, sofern ein Auftragsverarbeitungsvertrag mit dem Anbieter besteht, der ein Opt-out vom Training einschließt, das Modell nur die für die Extraktion notwendigen Daten erhält, die Aufbewahrungsfrist in der Datenschutzerklärung angegeben ist und in sensiblen Fällen eine EU-regionale Verarbeitung genutzt wird. In der Review-Oberfläche ist der Zugriff an die jeweilige Aufgabe gebunden und wird protokolliert.
Fazit
Die Dokumentenverarbeitung ist 2026 eines der KI-Projekte mit der sichersten Rendite, weil die Eingabe unstrukturiert, die Ausgabe dagegen präzise definierbar und die manuellen Kosten messbar sind. Der Unterschied zwischen Demo und Produktivsystem liegt nicht im Modell, sondern im Schema, in der Validierung, in der HITL-Oberfläche und im Eval-Set: Ohne diese Elemente bricht die Pipeline bei der ersten Formatänderung, und niemand bemerkt es.
Die praktische Reihenfolge: Sammeln Sie 100–200 reale Dokumente proportional nach Format, schreiben Sie das Schema mit zulässigem None und feldbezogener Konfidenz, bauen Sie die regelbasierte Validierung sowohl vor als auch nach dem LLM auf, und messen Sie die STP- und HITL-Quote vom ersten Tag an. Planen Sie die ERP-Integration in der Discovery-Phase, nicht erst am Ende.
Offizielle Quellen
Verwandte Artikel: KI-Agenten für KMU 2026, Prompt Engineering im Unternehmensumfeld, Schutz vor LLM-Halluzinationen.
Wenn bei Ihnen monatlich mehrere Hundert Rechnungen, Verträge oder Formulare manuell erfasst werden, vereinbaren Sie einen 30-minütigen Gesprächstermin: Wir gehen gemeinsam die Dokumenttypen, die ERP-seitigen Möglichkeiten und die zu erwartende STP-Quote durch und sagen Ihnen, ob es sich amortisiert. Die Pipeline bauen wir im Rahmen unserer Projekte für KI-Automatisierung in Ihrer eigenen Umgebung – die Dokumente verlassen Ihre Systeme nicht.