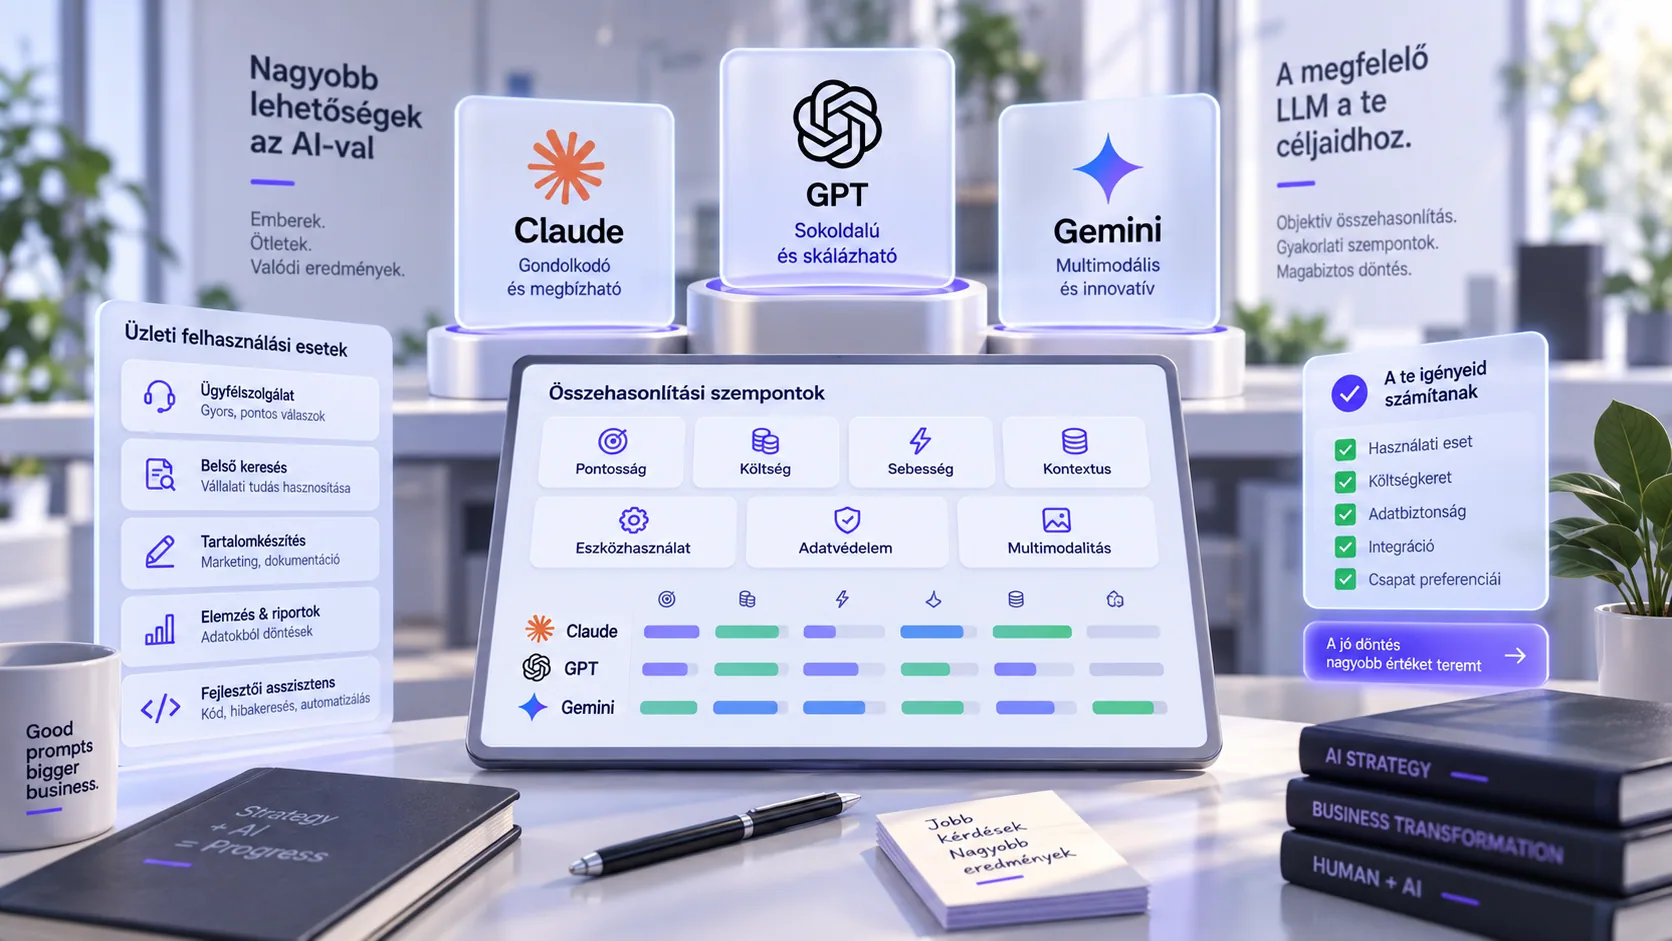
„Welches Modell sollten wir wählen?" ist die häufigste Frage, die wir beim ersten Gespräch zu einem KI-Projekt hören – und die am wenigsten hilfreiche. 2026 liegen die Hauptmodelle der drei großen Anbieter (Anthropic, OpenAI, Google) bei den meisten geschäftlichen Aufgaben in öffentlichen Benchmarks nur wenige Prozentpunkte auseinander, während der Unterschied bei Ihrer konkreten Aufgabe durchaus 15–20 Prozentpunkte betragen kann – nur eben nicht unbedingt in die Richtung, die die Rangliste nahelegt.
Dieser Artikel ist kein Ranking. Es ist eine Methode, mit der Sie für eine konkrete geschäftliche Aufgabe das richtige Modell auswählen: sechs Bewertungskriterien, eine Vergleichstabelle zum Stand des dritten Quartals 2026, Empfehlungen nach Aufgabentyp und ein Router-Muster mit Code, mit dem Sie sich nicht an einen einzigen Anbieter binden müssen.
Zwei Dinge vorab. Preise und Fähigkeiten ändern sich schnell: Jede Zahl versehen wir mit einem Datum und behandeln sie als Größenordnung. Das Zweite: Die Modellwahl beeinflusst nur 5–15 % der Projektkosten; den Rest machen Prompt, Eval-Set und Integration aus. Wenn Letztere nicht stimmen, rettet ein Modellwechsel gar nichts.
Am Ende des Artikels steht eine Checkliste, mit der Sie den Vergleich für Ihre eigene Aufgabe durchführen können. Die Methode ist dieselbe, die wir im Artikel KI-Implementierung bei ungarischen KMU für die Wahl des Anwendungsfalls beschrieben haben: eigene Daten, eigene Messung, datierte Entscheidung.
Nach welchen Kriterien sollte man ein LLM-Modell bewerten?
Sechs Kriterien, die wir bei jedem Projekt durchgehen. Die Reihenfolge ist keine Rangfolge – welches Kriterium stärker wiegt, entscheidet die Aufgabe.
1. Kontextfenster und tatsächliche Nutzbarkeit
2026 bieten alle drei Anbieter Modelle mit einem Kontext von über 200.000 Token an, die Gemini-Reihe sogar mit einem Fenster von über 1 Million. Die Größe ist jedoch nicht gleichbedeutend mit Nutzbarkeit: Informationen in der Mitte eines langen Kontexts finden die Modelle unterschiedlich zuverlässig wieder, und die Kosten fallen für die gesamte Eingabe an. Ein 300-seitiges Vertragspaket auf einmal einzuspeisen ist teurer und ungenauer als das RAG-basierte partielle Laden.
Wenn das Modell Tools aufrufen muss (CRM, ERP, Suche), lautet die Frage nicht, ob es das unterstützt, sondern wie zuverlässig es das richtige Tool wählt und die Parameter befüllt. Das lässt sich nur mit Ihrem eigenen Tool-Set messen. Das im Artikel KI-Agenten bei KMU beschriebene Pilotprojekt misst genau das.
3. Strukturierte Ausgabe
Rechnungsextraktion, Kategorisierung, Datenmigration: Die Ausgabe ist JSON, kein Fließtext. Alle drei Anbieter bieten schema-erzwungene Ausgaben (JSON Schema oder Ähnliches), aber die Quote gültiger JSON-Ausgaben und die Genauigkeit auf Feldebene unterscheiden sich je nach Aufgabe. Das messen Sie, statt es zu glauben.
4. Latenz
Bei einem Kundenservice-Chat sind 2 Sekunden bis zum ersten Token akzeptabel, 8 Sekunden nicht. Bei der Batch-Verarbeitung spielt die Latenz keine Rolle, entscheidend sind Durchsatz und Batch-Rabatt. Kleine Modelle sind 3- bis 5-mal schneller und bei vielen Klassifizierungsaufgaben ebenso genau.
5. Preis
Die Preise liegen im dritten Quartal 2026 größenordnungsmäßig bei: die kleinsten Modelle 0,1–0,5 USD pro Million Eingabe-Token, die mittleren 1–3 USD, die größten 5–15 USD; Ausgabe-Token kosten 3- bis 5-mal mehr. Die genauen Zahlen ändern sich quartalsweise, Prompt-Cache und Batch-API bringen 50–90 % Rabatt. Rechnen Sie auf HUF-pro-Aufgabe-Ebene, nicht auf Token-Preis-Ebene.
6. EU-Datenverarbeitung
In welcher Region die Verarbeitung läuft, ob ein Auftragsverarbeitungsvertrag (DPA) besteht, ob die Nutzung für Training ausgeschlossen ist und wie lange der Prompt gespeichert wird. 2026 bieten alle drei Anbieter Geschäftsbedingungen mit Trainings-Opt-out; eine EU-Regionsverarbeitung ist über die Cloud von Google (Vertex AI) und Microsoft (Azure OpenAI) sowie über einzelne Cloud-Partner von Anthropic verfügbar. Die Details behandeln wir im Artikel KI und DSGVO für ungarische Unternehmen.
Claude, GPT und Gemini im Vergleich – Stand Q3 2026
Die Tabelle vergleicht die Modellfamilien der drei Anbieter, nicht einzelne konkrete Versionen; bei jedem gibt es ein kleines, mittleres und großes Modell. Die Bewertung beruht auf den Erfahrungen aus unseren eigenen Projekten und Eval-Sets bis August 2026, nicht auf einem unabhängigen Benchmark.
| Kriterium |
Claude (Anthropic) |
GPT (OpenAI) |
Gemini (Google) |
| Kontextfenster |
200k+ Token |
200k–1M Token je nach Modell |
1M+ Token bei den Hauptmodellen |
| Tool-Use-Zuverlässigkeit |
Stark, native MCP-Unterstützung |
Stark, umfangreiches Ökosystem |
Gut, enge Anbindung an Google-Dienste |
| Strukturierte Ausgabe |
Schema-Erzwingung, tool-basiertes JSON |
JSON Schema Strict-Modus |
JSON Schema, response_schema |
| Verarbeitung langer Dokumente |
Hohe Genauigkeit bei mittlerer Länge |
Gut |
Stark bei sehr langer Eingabe |
| Ungarischsprachige Qualität |
Gute Formulierung, seltener Grammatikfehler |
Gut |
Gut, teils mit Anklang an Wort-für-Wort-Übersetzung |
| Latenz (mittleres Modell) |
1–3 s bis zum ersten Token |
1–3 s |
1–2 s |
| Preis (mittleres Modell, Q3 2026) |
1–3 USD / M Input |
1–3 USD / M Input |
0,5–2 USD / M Input |
| EU-Regionsverarbeitung |
Über Cloud-Partner (AWS/GCP EU) |
Azure OpenAI EU-Regionen |
Vertex AI EU-Regionen |
| Trainings-Opt-out mit Geschäftsbedingungen |
Ja |
Ja |
Ja (Vertex / kostenpflichtige API) |
| Prompt-Cache / Batch-Rabatt |
Ja / Ja |
Ja / Ja |
Ja / Ja |
Was die Tabelle nicht beantworten kann: Welches Modell bei Ihren Rechnungen, Ihren Tickets, Ihren Verträgen genauer ist. Dafür gibt es nur eine Methode: 50–100 reale Beispiele, derselbe Prompt, jeweils zwei Modelle der drei Anbieter, eine Tabelle mit Genauigkeit und Kosten in HUF pro Aufgabe.
Hinweis: Die öffentlichen Benchmarks (MMLU, HumanEval, SWE-bench und ähnliche) messen englischsprachige, klar definierte Aufgaben. Die Genauigkeit einer ungarischsprachigen Extraktionsaufgabe aus verrauschtem OCR-Text lässt sich daraus nicht ableiten. Der Benchmark eignet sich, um offensichtlich schwache Modelle auszuschließen; für die eigentliche Auswahl reicht er nicht.
Welches Modell eignet sich für welche geschäftliche Aufgabe?
Die folgenden Empfehlungen stammen aus unserer Erfahrung, und Ihr eigenes Eval-Set hat Vorrang vor ihnen. Das Muster ist jedoch stabil: kleines Modell dort, wo die Aufgabe klar abgegrenzt ist; großes Modell dort, wo Abwägung nötig ist; das mittlere reicht an den meisten Stellen aus.
| Aufgabentyp |
Empfohlene Größe |
Worauf Sie achten sollten |
| Klassifizierung, Etikettierung, Routing |
Kleines Modell |
Latenz und Preis; das große Modell ist hier Verschwendung |
| Strukturierte Extraktion (Rechnung, Formular) |
Mittel, mit Schema-Erzwingung |
Genauigkeit auf Feldebene, Quote gültiger JSON-Ausgaben |
| Zusammenfassung langer Dokumente |
Mittel oder groß, mit großem Kontext |
Die Abrufgenauigkeit in der Kontextmitte |
| Kundenservice-Antworten auf Ungarisch |
Mittel |
Formulierungsqualität, Halluzinationsrate |
| Agent, mehrstufiger Tool-Use |
Groß oder starkes mittleres Modell |
Zuverlässigkeit der Tool-Auswahl, Anzahl der Schritte |
| Codegenerierung, Refactoring |
Groß |
Testdurchlaufquote, nicht die Demo |
| Batch-Datenbereinigung |
Klein oder mittel, über die Batch-API |
Durchsatz, Batch-Rabatt |
Wenn das große Modell die falsche Wahl ist
Eine Pipeline, die täglich 5.000 E-Mails kategorisiert, kostet mit einem großen Modell zu den Preisen von 2026 monatlich 150.000–300.000 HUF, mit einem kleinen Modell 15.000–30.000 HUF – bei gleicher Genauigkeit, sofern die Kategorien klar definiert sind. Das große Modell ist dann gerechtfertigt, wenn es im Eval-Set messbar besser abschneidet und der Unterschied in Geld mehr wert ist als die Mehrkosten.
Wenn das kleine Modell die falsche Wahl ist
Ein Vertragsvergleich, bei dem die Frage lautet „Was hat sich zwischen den beiden Versionen geändert und ist das relevant?", oder ein 12-stufiger Agent, bei dem sich Fehler kumulieren: Hier kostet die Ungenauigkeit des kleinen Modells mehr, als der höhere Token-Preis des großen Modells ausmacht.
Ein konkretes Beispiel: Kundenservice-Pipeline mit drei Modellgrößen
Ein Webshop erhält täglich 800 eingehende Nachrichten per E-Mail und Chat. Die drei Schritte der Pipeline nutzen drei unterschiedliche Modellgrößen, und das ist keine Prinzipienentscheidung, sondern das Ergebnis des Eval-Sets.
Der erste Schritt ist die Klassifizierung: Bestellstatus, Rücksendung, Rechnung, Beschwerde, Sonstiges. Kleines Modell, 40 Token Ausgabe, 0,3 Sekunden, 0,2–0,5 HUF pro Nachricht. Im Eval-Set erreichte das kleine Modell 96 %, das große 97 %; der eine Prozentpunkt rechtfertigt nicht den zwanzigfachen Preis.
Der zweite Schritt ist die automatische Beantwortung von Bestellstatus- und Rücksendeanfragen: mittleres Modell, Tool-Use für die Bestell-API, 200–300 Token Antwort auf Ungarisch. Hier erreichte das kleine Modell nur 81 % (falsche Anrede, fehlende Schritte), das mittlere 93 %; der Unterschied zeigt sich im Kundenerlebnis, deshalb gewann das mittlere Modell.
Der dritte Schritt sind Beschwerden: Hier gibt es keine automatische Antwort, das große Modell erstellt eine Zusammenfassung und einen Vorschlag für den Sachbearbeiter, der die Entscheidung trifft. Täglich 60–80 solcher Nachrichten, 20–40 HUF pro Nachricht, weil der gesamte Verlauf eingesehen werden muss. Die gesamten LLM-Kosten für die 800 täglichen Nachrichten liegen damit 2026 größenordnungsmäßig bei 3.000–5.000 HUF, gegenüber 25.000–40.000 HUF, wenn jeder Schritt über das große Modell liefe.
Wie baut man eine Multi-Model-Architektur auf?
Sich 2026 auf einen einzigen Anbieter zu verlassen ist ein geschäftliches Risiko: Preisänderungen, Modell-Abkündigungen, regionale Verfügbarkeit, Ausfälle. Die Multi-Model-Architektur besteht aus drei Elementen: Abstraktionsschicht, Router, Fallback.
Abstraktionsschicht
Eine einzige interne Schnittstelle (complete(task, input)), hinter der die anbieterspezifischen Clients liegen. Die Prompts sind anbieterunabhängige Vorlagen, die Unterschiede (Tool-Format, Schema-Angabe) übernimmt der Adapter. Das ermöglicht, dass ein Wechsel zur Konfiguration wird, nicht zur Neuentwicklung.
Router
Der Router entscheidet nach Aufgabentyp, Eingabegröße und Sensibilität. Es braucht keinen „intelligenten" Router (der per LLM über das Modell entscheidet), sondern einen regelbasierten: berechenbar, testbar, günstig.
// Regelbasierter LLM-Router mit Abstraktionsschicht (TypeScript, vereinfacht)
type Provider = 'anthropic' | 'openai' | 'google';
type Tier = 'small' | 'medium' | 'large';

type Task = {
  kind: 'classify' | 'extract' | 'summarize' | 'agent' | 'chat';
  inputTokens: number;
  sensitive: boolean; // personenbezogene Daten → nur EU-Regions-Route
};

type Route = { provider: Provider; tier: Tier; region: 'eu' | 'global' };

const EU_ONLY: Provider[] = ['google', 'openai']; // Beispiel: Vertex EU, Azure EU Konfiguration

export function route(task: Task): Route {
  const region = task.sensitive ? 'eu' : 'global';
  const providers = task.sensitive ? EU_ONLY : (['anthropic', 'openai', 'google'] as Provider[]);

  let tier: Tier = 'medium';
  if (task.kind === 'classify') tier = 'small';
  if (task.kind === 'agent') tier = 'large';
  if (task.kind === 'summarize' && task.inputTokens > 150_000) tier = 'large';

  // Primärer Anbieter je nach Aufgabentyp; die Reihenfolge ist Konfiguration, kein Code.
  const preferred = PREFERENCE[task.kind].filter((p) => providers.includes(p));
  return { provider: preferred[0], tier, region };
}

export async function complete(task: Task, prompt: PromptTemplate, input: unknown) {
  const primary = route(task);
  const candidates = [primary, ...fallbacksFor(primary)];
  for (const r of candidates) {
    try {
      return await adapters[r.provider].complete({ ...r, prompt, input, timeoutMs: 20_000 });
    } catch (err) {
      if (!isRetryable(err)) throw err; // Schema-Fehler, Berechtigung: hier wird nicht blind auf Fallback gewechselt
      metrics.fallback(r, err);
    }
  }
  throw new Error('all providers failed');
}
Die PREFERENCE-Tabelle legt fest, welches kleine Modell welchen Anbieters bei der Klassifizierung an erster Stelle steht, welches mittlere bei der Extraktion, und so weiter. Das ergibt sich aus dem Ergebnis des Eval-Sets, und wir messen es vierteljährlich neu.
Fallback
Der Fallback ist nicht dasselbe wie der Router: Er greift, wenn der primäre Anbieter versagt (Timeout, 5xx, Rate Limit). Zwei Regeln: Bei einem Schema-Validierungsfehler wechseln wir nicht blind zu einem anderen Anbieter, weil der Fehler auch am Prompt liegen kann; und wir messen die Fallback-Quote, denn steigt sie über 5 %, stimmt etwas mit dem primären Anbieter nicht.
Aufgabe
Regelbasierter Router
Anbieter-Adapter
Fallback
Was kostet ein Anbieterwechsel?
Die Wechselkosten sind der am häufigsten unterschätzte Posten. Nicht die Umschreibung des Client-Codes ist teuer, sondern das, was drumherum liegt.
| Posten |
Mit Abstraktionsschicht |
Ohne |
| Client-Code |
Konfiguration, 0–1 Tag |
2–5 Tage |
| Prompts neu abstimmen |
2–5 Tage (je Modell unterschiedlicher Stil) |
5–10 Tage |
| Eval-Set erneut durchlaufen und vergleichen |
1–2 Tage, sofern ein Eval-Set existiert |
Kein Vergleichsmaßstab vorhanden |
| Tool-Schemas und strukturierte Ausgabe |
Übernimmt der Adapter |
Manuell, bei jedem Aufruf |
| Rechtlich: neuer DPA, Aktualisierung der Datenschutzerklärung |
1–3 Wochen Durchlaufzeit |
Dasselbe |
Der Wechsel ist dann günstig, wenn Eval-Set und Abstraktion von Anfang an vorhanden sind. Gibt es kein Eval-Set, wissen Sie nach dem Wechsel nicht, ob das System besser oder schlechter geworden ist; das ist das eigentliche Risiko, nicht der Code.
Tipp: Lassen Sie das Eval-Set bereits im ersten Projekt auf zwei Anbietern laufen, auch wenn Sie sich für einen entscheiden. Das Ergebnis des zweiten Anbieters ist ein fertiger Plan B in der Schublade: Kommt es beim ersten zu einer Preis- oder Konditionenänderung, können Sie innerhalb eines Tages entscheiden.
Warum reicht der Benchmark für die Modellwahl nicht aus?
Vier Gründe, warum die öffentliche Rangliste bei Ihrer Aufgabe in die Irre führen kann:
- Sprache. Die Benchmarks sind überwiegend englischsprachig. Die Genauigkeit der ungarischsprachigen Formulierung und des ungarischen Rechts- oder Buchhaltungsvokabulars kommt darin nicht vor.
- Aufgabenverteilung. Der Benchmark misst eine „durchschnittliche" Aufgabe; Ihre ist eine enge Verteilung (zum Beispiel die Rechnungsformate von 12 Lieferanten). Bei einer engen Verteilung kann sich die Rangfolge umkehren.
- Prompt-Sensibilität. Derselbe Prompt liefert je nach Modell eine unterschiedliche Qualität; der Benchmark wurde mit einem bestimmten Prompt-Set erstellt, nicht mit Ihrem.
- Veralterung. Die Modelle werden alle 3–6 Monate aktualisiert; das Benchmark-Ergebnis ist eine Momentaufnahme, Ihr eigenes Eval-Set können Sie jederzeit erneut durchlaufen lassen.
Die praktische Methode: Der Benchmark ist ein Filter (das untere Drittel der Liste fällt heraus), das Eval-Set trifft die Entscheidung. Der im Artikel Schutz vor LLM-Halluzinationen beschriebene Eval-Aufbau lässt sich hier eins zu eins anwenden.
Häufig gestellte Fragen
Welches LLM liefert präzisere ungarischsprachige Geschäftstexte?
Im dritten Quartal 2026 liefern die mittleren und großen Modelle aller drei Anbieter brauchbaren ungarischen Text; der Unterschied variiert je nach Aufgabe und lässt sich mit dem eigenen Eval-Set anhand von 50–100 Beispielen innerhalb eines Tages messen. Vergleichen Sie statt der Rangliste die gemessene Genauigkeit und die Kosten in HUF pro Aufgabe.
Lohnt es sich, mehrere LLM-Anbieter gleichzeitig zu nutzen?
Ja, sofern eine Abstraktionsschicht vorhanden ist: Routing nach Aufgabentyp (kleines Modell für Klassifizierung, großes für Agenten) bringt einen 3- bis 10-fachen Kostenunterschied, und der zweite Anbieter dient als Fallback bei Ausfall oder Preisänderung. Der Mehraufwand ist eine Adapterschicht, die in einem mittelgroßen Projekt 2–4 Tage dauert.
Wie kann ich ein LLM so einsetzen, dass die Daten in der EU bleiben?
Eine EU-Regionsverarbeitung ist 2026 über die EU-Regionen von Google Vertex AI und Microsoft Azure OpenAI sowie über Cloud-Partner von Anthropic verfügbar; die Geschäftsbedingungen aller drei Anbieter enthalten einen Trainings-Opt-out und einen DPA. Bei personenbezogenen Daten sollte der Router ausschließlich die EU-Regions-Route zulassen.
Was kostet eine LLM-basierte Aufgabe im Jahr 2026?
Größenordnungsmäßig: Klassifizierung mit kleinem Modell 0,1–1 HUF pro Aufgabe, strukturierte Extraktion mit mittlerem Modell 5–30 HUF pro Dokument, mehrstufiger Agentenlauf 30–500 HUF. Der Token-Preis ändert sich quartalsweise; Prompt-Cache und Batch-API sparen bei den passenden Aufgaben 50–90 %.
Fazit
Die Modellwahl ist 2026 keine Markenfrage. Die Hauptmodelle der drei großen Anbieter liegen nahe beieinander; der bei Ihrer Aufgabe gemessene Unterschied ist das Einzige, was zählt, und den können Sie nur mit einem eigenen Eval-Set messen. Die sechs Kriterien (Kontext, Tool-Use, strukturierte Ausgabe, Latenz, Preis, EU-Datenverarbeitung) wiegen je nach Aufgabe unterschiedlich schwer, deshalb gibt es keine einzige richtige Antwort, sondern nur eine für die jeweilige Aufgabe richtige.
Die Architektur ist wichtiger als die Wahl: Abstraktionsschicht, regelbasierter Router, gemessener Fallback. Damit wird ein Modellwechsel zur Konfiguration statt zum Projekt, und eine Preisänderung oder Abkündigung wird nicht zum Risiko, sondern zu einer Entscheidung, die an einem Tag getroffen werden kann.
Die praktische Reihenfolge: Beschreiben Sie das Aufgabenprofil, sammeln Sie 50–100 reale Beispiele, lassen Sie sie auf zwei bis drei Modellen laufen, tragen Sie Genauigkeit und Kosten in HUF pro Aufgabe in eine Tabelle ein und entscheiden Sie anhand dieser Tabelle. Wiederholen Sie das vierteljährlich.
Offizielle Quellen
Verwandte Artikel: KI-Agenten bei KMU 2026, Aufbau eines RAG-Chatbots, KI und DSGVO für ungarische Unternehmen.
Wenn Sie für eine konkrete Aufgabe ein Modell auswählen möchten, oder Ihr bestehendes System an einen einzigen Anbieter gebunden ist und Sie das auflösen wollen, vereinbaren Sie einen 30-minütigen Anruf: Wir gehen das Aufgabenprofil gemeinsam durch und sagen Ihnen, was sich zu messen lohnt, bevor Sie irgendetwas umschreiben. In unseren KI-Automatisierungs-Projekten ist das die Aufgabe der ersten Woche.