Ein Chatbot vom Typ „Fragen Sie unsere Dokumente" ist 2026 kein experimenteller Use Case mehr. Kunden erwarten ihn, die LLM-APIs sind stabil, die Vector-DBs sind günstig. Der schwierige Teil ist nicht der funktionierende Prototyp, sondern das verlässliche Produktionssystem — eines, das tatsächlich aus den Quelldokumenten antwortet, nicht halluziniert und messbar präzise ist.
In diesem Artikel betrachten wir den tatsächlichen Produktions-RAG-Stack: Architektur, Toolauswahl, Ingestion-Pipeline, Umgang mit Halluzinationen und Kosten. Die Beispiele sind auf eine mittelgroße Unternehmenswissensbasis (5.000–50.000 Dokumente) ausgelegt. Wir arbeiten mit Implementierungen, die wir unter echtem Produktionstraffic gemessen haben, nicht mit Konferenz-Folien.
Was ist RAG, und warum reicht ein einfacher ChatGPT-API-Aufruf nicht aus
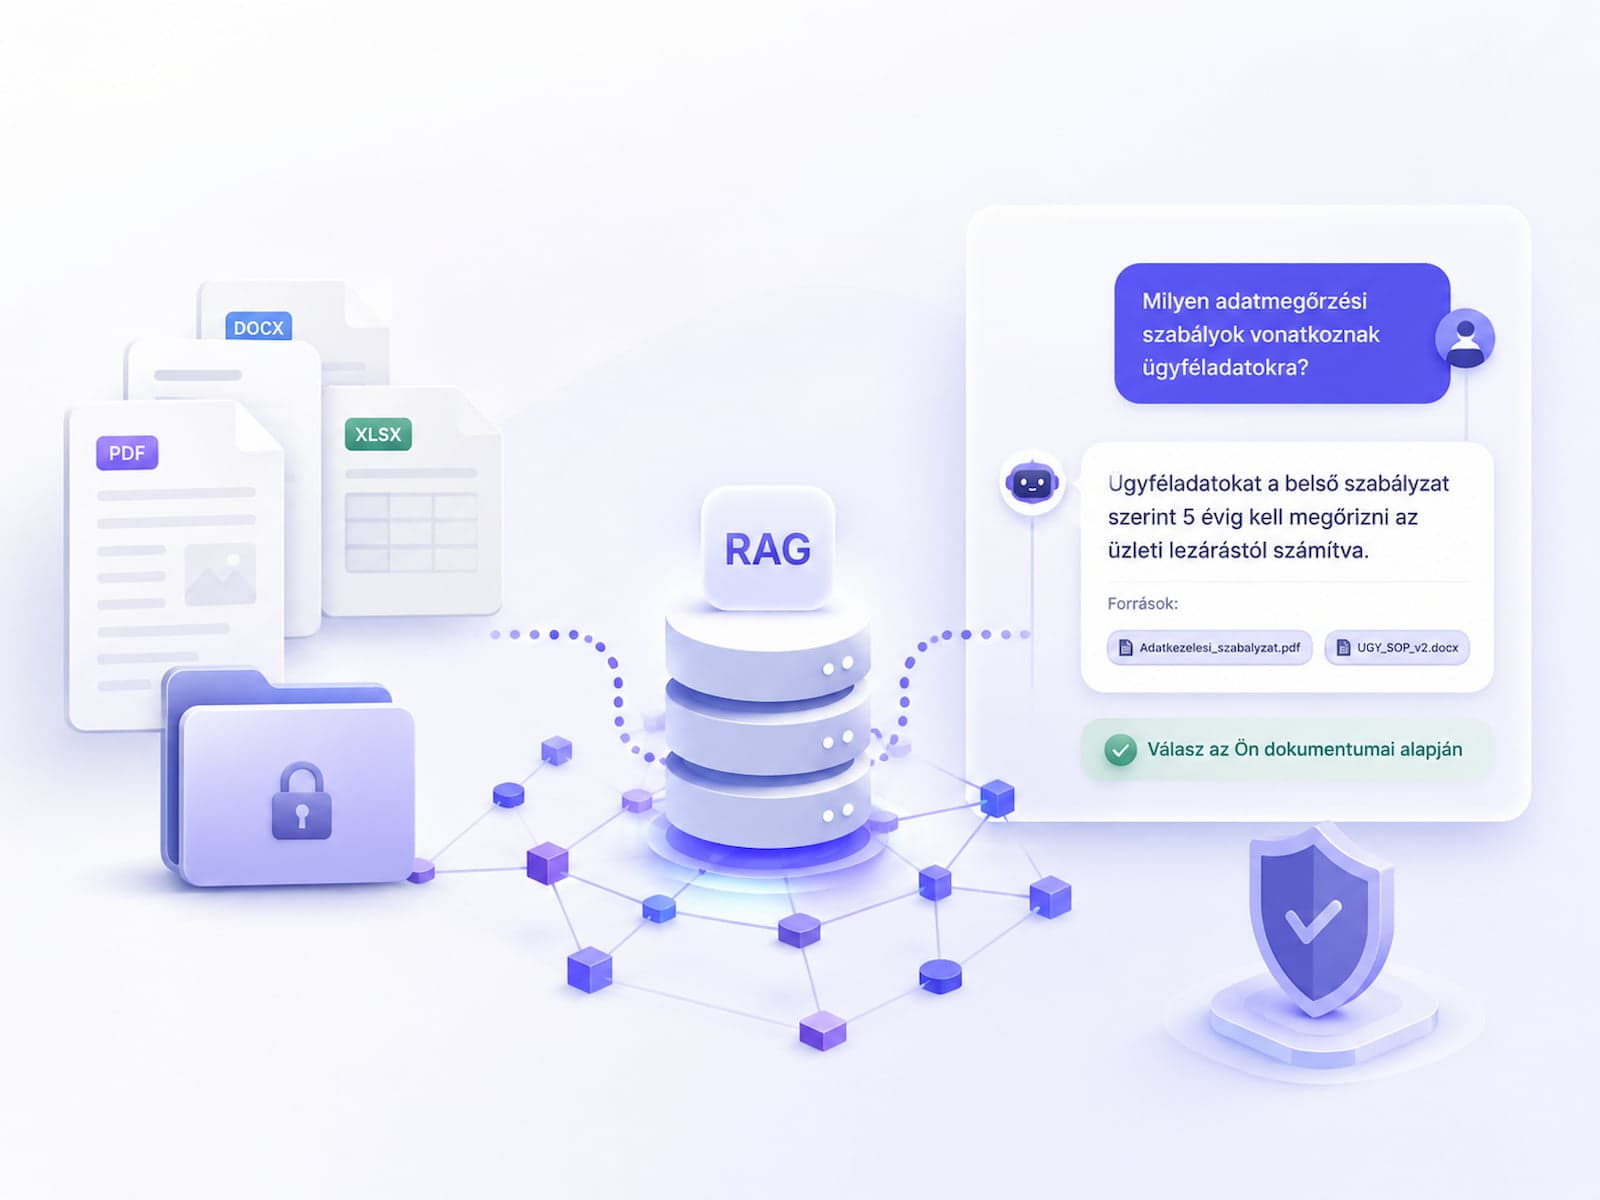
„Retrieval-Augmented Generation" (RAG) löst das Problem, dass das Basismodell Ihre Dokumente nicht kennt. Wenn Sie GPT-4o direkt fragen, „was steht im Liefer-SLA-Dokument von 2024 zum Q4-Schwellenwert für die Abwanderungsquote", lautet die Antwort entweder „das weiß ich nicht" oder eine plausibel klingende, aber erfundene Zahl. Das Modell war nicht dabei, als das Dokument entstand — Inhalte, die nach dem Trainings-Cutoff veröffentlicht wurden, sind für es unsichtbar.
RAG arbeitet in drei Schritten. Zunächst wird die Nutzerfrage in einen hochdimensionalen Vektor (Embedding) umgewandelt, danach sucht die Vector-DB die Top-k nächstgelegenen Dokument-Ausschnitte, und schließlich erhält das LLM diesen Kontext zusammen mit der Frage und antwortet auf dessen Basis. Der „einfache ChatGPT-API-Aufruf" führt nur Schritt 3 aus — ohne Kontext.
Warum reicht Fine-Tuning nicht aus?
Fine-Tuning ist ein alternativer Ansatz, löst aber ein anderes Problem. Es passt den Stil, das Format und die Domänenwissen-Reflexe des Modells an, bringt aber keine aktuellen Inhalte. Ändert sich das Unternehmens-SLA-Dokument morgen, weiß das feinabgestimmte Modell davon nichts, bis Sie es neu trainieren — ein Vorgang, der 10.000-20.000 Dollar kostet und mehrere Tage für den kompletten Loop braucht.
RAG hingegen lässt sich sofort aktualisieren: Sobald Sie das neue Dokument in die Vector-DB importieren, hat das Modell Zugriff darauf. Die beiden Techniken werden oft kombiniert: Fine-Tuning für den Tonfall, RAG für den Inhalt. In den meisten Produktionssystemen reicht RAG allein aus; Fine-Tuning kommt nur dann ins Spiel, wenn Tonfall und strukturierte Ausgabe eindeutig nicht passen.
Warum reicht ein langes Context-Window nicht aus?
Die GPT-4o- und Claude-Sonnet-4-Modelle von 2026 verfügen über einen Context von 200K+ Token. Da liegt die Frage nahe: Wozu eine Vector-DB, wenn wir den gesamten Dokument-Corpus in den Prompt packen können? Aus drei Gründen:
- Kosten. 50.000 Dokumente × durchschnittlich 1.000 Token = 50 Millionen Token pro Query. Bei einem GPT-4o-Input-Tarif von 2,5 Dollar / 1M Token ergibt das 125 Dollar pro Frage. Das bezahlt niemand.
- Latenz. Die Verarbeitung von 200K Input-Token dauert 8–15 Sekunden. Bis dahin hat der Nutzer den Tab längst geschlossen.
- Genauigkeit. Bei langem Context tritt der „Lost in the Middle"-Effekt auf: Informationen in den mittleren 50 % spiegeln sich oft nicht in der Antwort wider. Die von RAG ausgewählten Top-k-Ausschnitte bieten konzentrierte Relevanz.
Tipp: RAG ersetzt weder Fine-Tuning noch langen Context — die drei lösen unterschiedliche Probleme. In Produktionssystemen sind häufig alle drei vorhanden: ein feinabgestimmtes Basismodell + RAG-Retrieval + gezielter Long-Context (z. B. für Zusammenfassungen).
Architekturüberblick — drei Layer + Eval
Jedes RAG-System besteht aus drei Hauptschichten:
- Ingestion — Dokumentenimport, Chunking, Embedding-Berechnung, Schreiben in die Vector-DB. In der Regel ein Offline-Batch-Prozess, der täglich oder wöchentlich aktualisiert wird.
- Retrieval — Die Nutzerfrage trifft ein, das Embedding wird berechnet, die Vector-DB liefert die Top-k-Treffer. Online, latenzsensibel (Ziel: < 200 ms).
- Generation — Das LLM erhält Kontext und Frage und antwortet mit Quellenangabe. Online, typische Latenz 2–5 s.
Daneben ist eine Eval-Pipeline notwendig, die anhand von 50–200 manuell gelabelten Frage-Antwort-Paaren die Genauigkeit misst. Ohne Eval wissen Sie nicht, ob die gestrige Prompt-Änderung etwas verbessert oder verschlechtert hat — die Produktion läuft blind.
Layer 1 im Detail: Ingestion
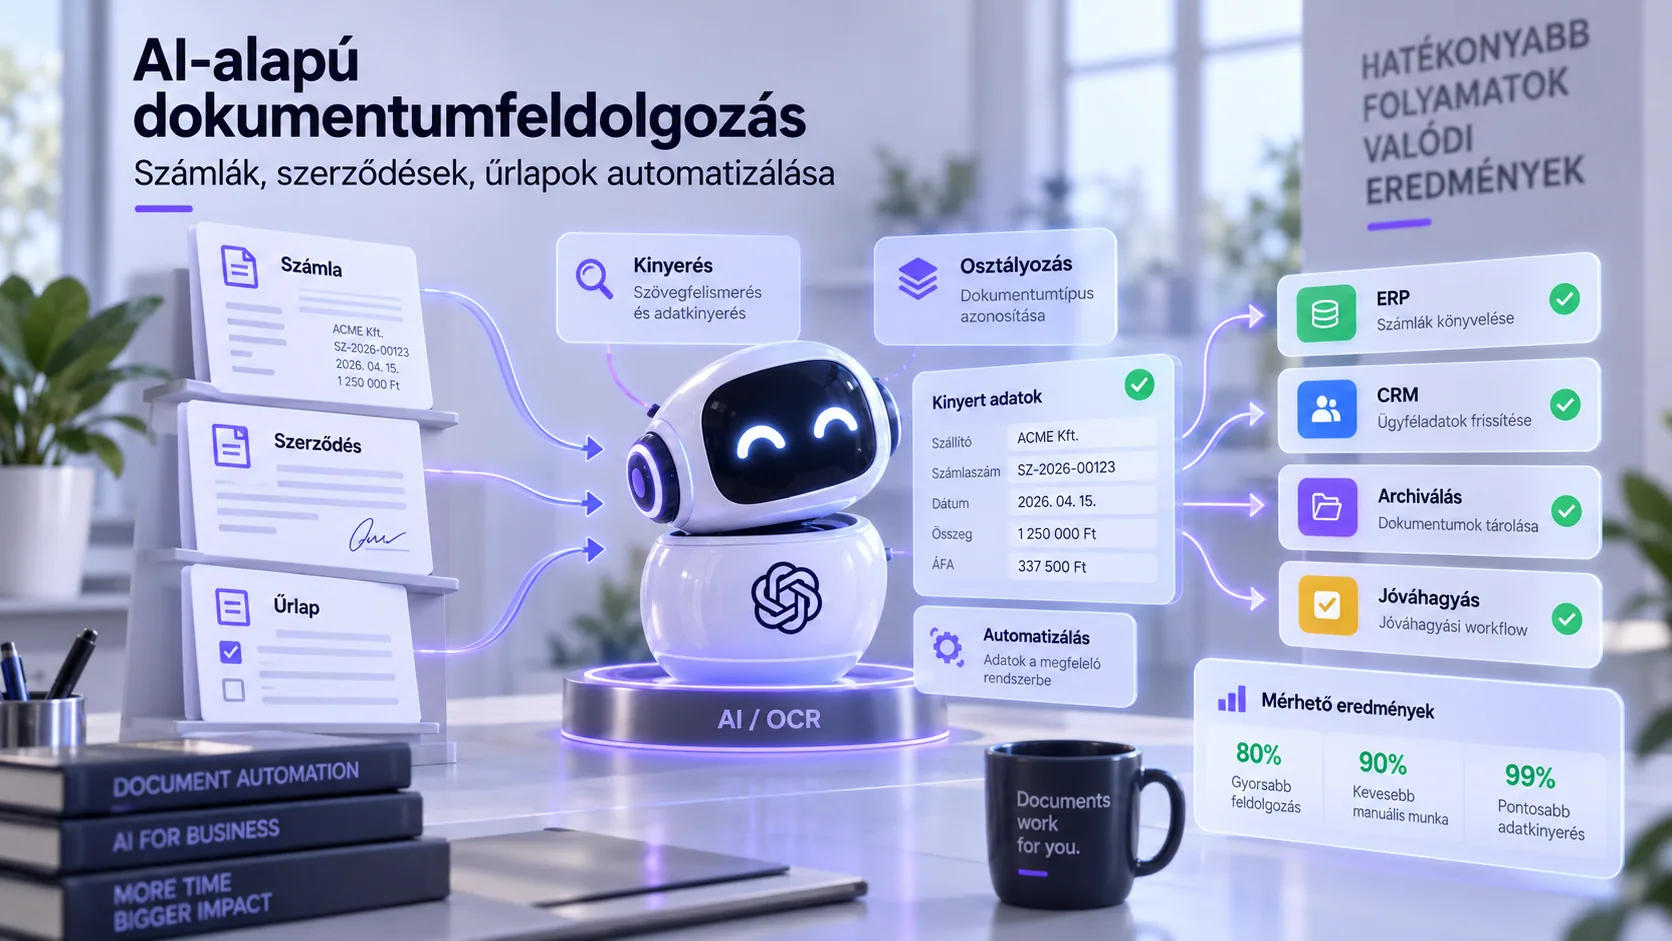
Die Ingestion-Pipeline besteht aus mindestens 4 Schritten: Dokumenten-Laden (PDF, Word, HTML, Markdown), Bereinigung (Entfernen von Header/Footer, OCR-Korrekturen), Chunking (siehe unten), Embedding-Berechnung (gebündelte API-Aufrufe) und Schreiben in die Vector-DB. Der erste Import eines mittelgroßen Corpus (50.000 Dokumente) dauert 2–6 Stunden, spätere Updates laufen inkrementell.
Genau hier lauern die Fallstricke. Aus einem 200-seitigen PDF können 600 Chunks entstehen; sind 10 % davon Header-Rauschen, verschmutzen bereits 60 unbrauchbare Vektoren Ihre Suchergebnisse.
Layer 2 im Detail: Retrieval
Der Retrieval-Layer wirkt nur auf den ersten Blick trivial (Frage rein → Embedding → Vector-DB → Top-k). In Wirklichkeit steckt hier das meiste Feintuning-Potenzial: Query Expansion, Hybrid Search (BM25 + Vector), Metadaten-Filter, Reranking. Dazu weiter unten mehr.
Layer 3 im Detail: Generation
Der Generation-Layer ist die Kombination aus System-Prompt, Context-Injection und Citation-Enforcement. Auch die Modellparameter (Temperature, Top_p, Max_tokens) gehören hierher. Ein gut designter Generation-Layer hebt das Ergebnis von einer Baseline von 60–70 % auf 90 %+ Genauigkeit — allerdings nur, wenn auch das Retrieval stimmt.
Chunking-Strategie — hier scheitern die meisten Projekte
Der Ansatz „wir laden einfach alle Dokumente in die Vector-DB" bringt 60–70 % Genauigkeit — für ein echtes Produktionsergebnis braucht es eine Chunking-Strategie.
Fixed-Size-Chunking
Die einfachste Methode: Sie schneiden nach jeweils N Zeichen (oder Token). Schnell, deterministisch, leicht reproduzierbar.
def fixed_chunks(text: str, size: int = 800, overlap: int = 120):
    chunks = []
    start = 0
    while start < len(text):
        end = min(start + size, len(text))
        chunks.append(text[start:end])
        start += size - overlap
    return chunks
Problem: Der Schnitt kann mitten im Satz erfolgen, der Kontext wird abgebrochen. „Der Vertrag ist einzeln zu erstatten..." — und hier endet er. Das LLM weiß nicht, wie es weitergeht.
Recursive Character Splitting
Der LangChain RecursiveCharacterTextSplitter ist klüger: Er folgt einer hierarchischen Liste von Separatoren. Zuerst versucht er, an Absätzen zu schneiden (\n\n), ist das zu groß, auf Satzebene (. ), und zuletzt bei Wörtern ( ).
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=800,
    chunk_overlap=120,
    separators=["\n\n", "\n", ". ", " "],
    length_function=len,
)

chunks = splitter.split_documents(documents)
chunk_size=800 Zeichen (~150 Token) und chunk_overlap=120 sind Industriestandard. Der Overlap sorgt dafür, dass der betroffene Satz, falls der Schnitt an einer ungünstigen Stelle erfolgt ist, im nächsten Chunk erneut auftaucht.
Semantic Chunking
Die Generation 2025–2026: Mit einem LLM oder Embedding-Modell werden die semantischen Grenzen erkannt. Dort, wo die Cosine-Similarity der umliegenden Sätze plötzlich abfällt (>0,2 Drop), wird geschnitten.
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai.embeddings import OpenAIEmbeddings

text_splitter = SemanticChunker(
    OpenAIEmbeddings(model="text-embedding-3-small"),
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=95,
)

chunks = text_splitter.create_documents([long_text])
Teurer (jeder Satz wird einmal embedded), erhält aber die Kohärenz. In einer KMU-Domäne bringt es +5–8 Prozentpunkte Genauigkeitsverbesserung gegenüber dem Recursive Splitting.
Dokumenttyp-spezifisches Chunking
Nicht jedes Dokument ist gleich. Ein Vertragstext hat eine andere Struktur als eine Marketing-FAQ:
| Dokumenttyp |
Chunk-Größe |
Overlap |
Anmerkung |
| PDF, juristischer Text |
500–600 |
150 |
Viele Querverweise, großer Overlap nötig |
| Technische Spezifikation |
800 |
100 |
Gut strukturiert, kleinerer Overlap reicht |
| Marketinginhalt, FAQ |
1200 |
80 |
Eigenständige Absätze, geringer Overlap |
| Code-Dokumentation |
600 |
200 |
Integrität der Code-Blöcke muss erhalten bleiben |
| E-Mail-Archiv |
400 |
50 |
Kurze Nachrichten, minimaler Overlap |
Die Erkennung des Dokumenttyps lässt sich einfacher metadatengesteuert umsetzen als per LLM: Die Ordnerstruktur documents/legal/*.pdf liefert bereits den Hinweis.
Achtung: Das Chunking lässt sich nicht nachträglich anpassen. Ist Ihre Vector-DB bereits befüllt und Sie ändern die Chunk-Größe, muss jedes Dokument neu embedded werden — und das kostet spürbar. Das Re-Chunking eines Corpus mit 50.000 Dokumenten kostet ~10–30 Dollar, plus 2–4 Stunden Laufzeit.
Auswahl des Embedding-Modells
Die drei zentralen Entscheidungen sind: Vector-DB, Embedding-Modell, LLM. Über das Embedding-Modell wird oft am wenigsten gesprochen, dabei bestimmt es grundlegend die Retrieval-Qualität.
| Modell |
Dimension |
Kosten / 1M Token |
Ungarische Sprache |
Anmerkung |
| OpenAI text-embedding-3-small |
1536 |
$0,02 |
Gut |
Standardwahl |
| OpenAI text-embedding-3-large |
3072 |
$0,13 |
Ausgezeichnet |
Teurer, marginaler Zugewinn |
| Cohere embed-multilingual-v3 |
1024 |
$0,10 |
Ausgezeichnet |
Fokus auf Mehrsprachigkeit |
| Voyage AI voyage-3 |
1024 |
$0,06 |
Gut |
Neu, schnell |
| BAAI/bge-large-en-v1.5 (Open Source) |
1024 |
$0 + Infra |
Mittelmäßig (english-first) |
Self-hosted |
| intfloat/multilingual-e5-large (Open Source) |
1024 |
$0 + Infra |
Ausgezeichnet (95+ Sprachen) |
Self-hosted |
Für ungarischsprachige Inhalte sind text-embedding-3-small oder Cohere embed-multilingual-v3 am zuverlässigsten. text-embedding-3-large ist 6-mal teurer, bringt aber in einer klassischen KMU-Domäne nur 1–2 Prozentpunkte realen Precision-Zugewinn gegenüber dem Small-Modell.
Self-hosted-Option: intfloat/multilingual-e5-large ist gut (~85–90 % der Precision der Managed-Alternativen), und in DSGVO-sensiblen Domänen verlässt das Daten den eigenen Server nie.
Wechsel des Embedding-Modells — teurer, als Sie denken
Wechseln Sie zwischendurch das Embedding-Modell (z. B. von text-embedding-3-small zu text-embedding-3-large), müssen alle Vektoren neu berechnet werden. Für einen Corpus mit 50.000 Chunks kostet das Re-Embedding ~50 Dollar, plus 1–2 Stunden Laufzeit. Planen Sie das bereits in der Discovery-Phase ein.
Auswahl der Vector-DB — Vergleichsmatrix
Der Vector-DB-Markt ist 2026 ausgereift. Fünf Hauptoptionen, jede für einen anderen Use Case.
| DB |
Self-hosted |
Managed |
Filter-Support |
Hybrid (BM25+Vec) |
Einstiegspreis |
DSGVO EU |
| pgvector (Postgres) |
Ja |
Supabase/Neon |
Ausgezeichnet (SQL) |
Ja (pg_trgm + vec) |
$0 self / $25 Supabase |
Ja |
| Pinecone |
Nein |
Ja |
Gut |
Ja (Hybrid-Index) |
$70/Monat |
EU-Region opt-in |
| Weaviate |
Ja |
Weaviate Cloud |
Gut |
Ja |
$0 self / $25 Cloud |
Ja |
| Qdrant |
Ja |
Qdrant Cloud |
Gut |
Ja |
$0 self / $25 Cloud |
Ja |
| Chroma |
Ja |
Chroma Cloud |
Mittelmäßig |
Limited |
$0 self |
Ja (self) |
| Milvus |
Ja |
Zilliz Cloud |
Gut |
Ja |
$0 self / $99 Cloud |
Ja |
pgvector — der Corevanix-Standard
In den meisten KMU-Projekten setzen wir auf pgvector. Aus sieben Gründen:
- Postgres läuft bereits. Auf dem bestehenden DB-Server reicht
CREATE EXTENSION vector; — fertig. Kein neuer Vendor, kein neues Monitoring, keine neue Backup-Strategie.
- Native SQL-Filter.
WHERE metadata->>'category' = 'legal' AND created_at > '2025-01-01' ist einfaches SQL.
- Transaktionale Garantien. Laufen Embedding-Berechnung und Chunk-Speicherung in einer Transaktion, hinterlassen Teilfehler keine verwaisten Chunks.
- Backup- und Disaster-Recovery-Routine. Die vorhandene Postgres-Backup-Pipeline schließt die Vektordaten automatisch mit ein.
- Kosten. 50.000 Dokumente × 4 Chunks × 1536 Dimensionen × 4 Byte ≈ 1,2 GB. Das passt problemlos in ein 25-Dollar-Supabase-Projekt.
- DSGVO-freundlich. In der EU-Region gehostetes Postgres, die Daten wandern nie auf einen US-Server.
- Einfache Migration. Muss irgendwann zu Pinecone gewechselt werden (weil Sie z. B. 10M+ Chunks speichern), lässt sich alles mit einem SELECT exportieren.
Pinecone — wann ist es die bessere Wahl?
Speichern Sie 10M+ Chunks, brauchen Sie eine p99-Latenz unter 100 ms, oder passt die organisatorische Last des Sharding nicht ins Team, dann kommen Pinecone oder Qdrant Cloud ins Spiel. Im KMU-Maßstab (50K–2M Chunks) reicht pgvector völlig aus.
Index-Typ: HNSW vs. IVF
Beide sind gängige Optionen (HNSW: Hierarchical Navigable Small World; IVF: Inverted File Index). HNSW ist präziser und bei der Query-Zeit schneller, benötigt dafür aber mehr Arbeitsspeicher. IVF ist günstiger, erfordert aber Parametrierung (nprobe, nlist).
Für einen KMU-großen Corpus: HNSW als Standard, mit den Parametern m=16, ef_construction=64. Ab 10M+ Chunks lohnt sich wegen der Speicherkosten der Wechsel zu IVF-PQ (quantisiert).
-- pgvector HNSW-Index
CREATE INDEX ON chunks
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
Query-Handling und Context-Injection
Ist die Nutzerfrage kurz ("SLA"), wird das Embedding nicht aussagekräftig. Ist sie lang und voller Rauschen ("hi, ich wollte nur kurz fragen, ob im Q4-SLA..."), ist das Embedding genauso schlecht. Zwei Techniken schaffen Abhilfe: Query Rewriting und HyDE.
Query Rewriting
Mit dem LLM formulieren wir die Frage in 2–3 Varianten um, jede geht ins Retrieval, und wir bilden die Vereinigung der Top-k-Ergebnisse.
expansion_prompt = """
Formulieren Sie 3 alternative Varianten der folgenden Frage,
die für die Vektorsuche nützlich sind.
Jede Variante 1-2 Sätze, keyword-orientiert.

Frage: {user_query}

Geben Sie nur die 3 Alternativen aus, eine pro Zeile, ohne Nummerierung.
"""

alternatives = llm.generate(expansion_prompt.format(user_query=q)).split("\n")
all_chunks = []
for alt in [q] + alternatives:
    embedding = embed(alt)
    chunks = vector_db.search(embedding, top_k=10)
    all_chunks.extend(chunks)

deduplicated = deduplicate_by_chunk_id(all_chunks)
top_k = rerank_or_truncate(deduplicated, k=5)
Query Rewriting bringt im Durchschnittsfall +6–10 Prozentpunkte Recall-Verbesserung, kostet dafür aber einen zusätzlichen LLM-Aufruf — $0,001–0,005 / Query.
HyDE — Hypothetical Document Embeddings
Eine fortgeschrittenere Technik: Wir lassen das LLM eine fiktive Antwort auf die Frage generieren und verwenden deren Embedding für das Retrieval. Die Logik dahinter: Die fiktive Antwort verwendet hypothetisch denselben Wortschatz wie das echte Quelldokument.
hyde_prompt = """
Stellen Sie sich für die folgende Frage eine 3-5-sätzige Antwort vor,
so als hätten Sie sie aus einem internen Dokument kopiert.
Seien Sie technisch und spezifisch, auch wenn die Antwort erfunden ist.

Frage: {user_query}
"""

fake_answer = llm.generate(hyde_prompt.format(user_query=q))
query_embedding = embed(fake_answer)  # NICHT die ursprüngliche q wird embedded
chunks = vector_db.search(query_embedding, top_k=5)
HyDE bringt in schwierigen Domänen (juristisch, medizinisch, technisch) +5–12 Prozentpunkte Recall-Verbesserung. Kombinieren Sie aber nicht zu viel: Query Rewriting + HyDE + Reranking zusammen verlangsamen die Pipeline, und der marginale Zugewinn sinkt.
Hybrid Search — BM25 + Vector
Pure Vector Search kommt gut mit Synonymen und Kontext zurecht, reagiert aber schlecht auf seltene, spezifische Schlüsselwörter. Bei einer Anfrage wie „Rundschreiben KÜL-2024-7" ist die klassische Volltextsuche (BM25) besser.
Die Lösung: Hybrid Search. Sowohl BM25 als auch Vector Search laufen, die Ergebnisse werden per Reciprocal Rank Fusion zusammengeführt.
def reciprocal_rank_fusion(results_lists, k=60):
    scores = {}
    for results in results_lists:
        for rank, doc in enumerate(results):
            doc_id = doc["id"]
            scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)
    sorted_docs = sorted(scores.items(), key=lambda x: -x[1])
    return [doc_id for doc_id, _ in sorted_docs]

bm25_results = bm25_search(query, top_k=20)
vector_results = vector_search(query_embedding, top_k=20)
fused = reciprocal_rank_fusion([bm25_results, vector_results], k=60)
final = fused[:5]
Auf pgvector lässt sich Hybrid Search mit einer SQL-CTE implementieren:
WITH semantic AS (
  SELECT id, 1 - (embedding <=> $1) AS sim
  FROM chunks ORDER BY embedding <=> $1 LIMIT 20
),
keyword AS (
  SELECT id, ts_rank(to_tsvector('simple', content), plainto_tsquery($2)) AS rank
  FROM chunks WHERE to_tsvector('simple', content) @@ plainto_tsquery($2) LIMIT 20
)
SELECT id, COALESCE(sim, 0) * 0.7 + COALESCE(rank, 0) * 0.3 AS score
FROM semantic FULL OUTER JOIN keyword USING (id)
ORDER BY score DESC LIMIT 5;
Die Gewichtung 0.7 / 0.3 ist use-case-abhängig. In der juristischen Domäne 0.4 / 0.6 (BM25 stärker gewichtet), in der Marketing-Domäne 0.8 / 0.2 (Vector stärker gewichtet).
Reranking — die letzten 10 Prozentpunkte Precision-Gewinn
Die Vector Search liefert den relevanten Chunk oft innerhalb der Top 20, aber nicht auf Platz 1. Das Reranker-Modell ist ein zweiter Durchlauf: Es ordnet die 20 Kandidaten-Chunks feiner und wählt die Top 5 aus.
Die zwei gängigsten Optionen:
- Cohere Rerank 3 — Managed API, $1 / 1000 Rerank-Aufrufe, exzellente Qualität, auch für ungarischsprachige Inhalte gut.
- BAAI/bge-reranker-large — Open Source, self-hostbar, kostenlos, gute Qualität (~5–10 % schwächer als Cohere).
import cohere

co = cohere.Client(api_key="...")

reranked = co.rerank(
    model="rerank-multilingual-v3.0",
    query=user_query,
    documents=[c["content"] for c in top_20_chunks],
    top_n=5,
)
final_chunks = [top_20_chunks[r.index] for r in reranked.results]
Reranking bringt in schwierigen Domänen +8–15 Prozentpunkte Precision-Verbesserung. Die Latenzkosten liegen bei ~100–200 ms (Cohere) bzw. 50–100 ms (self-hosted BGE auf GPU).
Tipp: Ohne Reranking sind oft nicht Ihre Top-5-Chunks die wirklich relevanten, sondern eher der Chunk auf Platz 2 und der auf Platz 7. Bei einer 5-elementigen Context-Injection macht das den Unterschied zwischen „die Antwort ist enthalten" und „nahe an der Antwort, aber falsch".
Citation und Confidence Scoring
Die Context-Injection: Wir übergeben die Top-k-Chunks im System-Prompt und weisen das Modell explizit an, nur aus den Quellen zu antworten und die Quelle zu zitieren.
Sie sind ein interner Dokumenten-Assistent.
Antworten Sie ausschließlich auf Basis der Informationen in den folgenden QUELLEN.
Enthalten die Quellen keine Antwort, sagen Sie:
"Ich habe in den Dokumenten keine eindeutige Antwort gefunden."

Belegen Sie jede Aussage mit einer Citation: [chunk_X]
Die Citation ist verpflichtend, nicht optional.

Geben Sie am Ende der Antwort einen CONFIDENCE-Score auf einer Skala von 0-100 an:
- 90-100: Die Quellen belegen es eindeutig
- 70-89: Belegt, aber mit teilweiser Schlussfolgerung
- 50-69: Teilweise belegt, einige Details fehlen
- <50: Unzureichende Quellenlage, Antwort unsicher

QUELLEN:
[chunk_1] {content_1}
[chunk_2] {content_2}
[chunk_3] {content_3}
[chunk_4] {content_4}
[chunk_5] {content_5}

FRAGE: {user_query}
In der Post-Processing-Phase laufen zwei Prüfungen:
def validate_response(response: str) -> dict:
    citations = re.findall(r"\[chunk_\d+\]", response)
    confidence_match = re.search(r"CONFIDENCE:\s*(\d+)", response)
    confidence = int(confidence_match.group(1)) if confidence_match else 0
    return {
        "has_citations": len(citations) > 0,
        "citation_count": len(citations),
        "confidence": confidence,
        "valid": len(citations) > 0 and confidence >= 50,
    }
Ist valid=False, wird automatisch die Ausgabe „ich habe keine eindeutige Antwort gefunden" ausgegeben, zusätzlich wird ein Log-Eintrag in die Human-Review-Queue geschrieben.
Hallucination-Management — Schutz in 3 Layern
Über den 7-schichtigen Schutz gegen Halluzinationen schreiben wir ausführlich in einem eigenen Artikel: 7 Schutzmaßnahmen gegen LLM-Halluzinationen. Hier der RAG-spezifische Teil:
- Confidence Threshold: Liegt die Top-1-Cosine-Similarity unter 0,7, erfolgt automatisch die Ausgabe „keine relevante Antwort". Das ist unabhängig von der LLM-Antwort — ein Signal auf Retrieval-Ebene.
- Citation Requirement: Der System-Prompt fordert explizit die Quellenkennung an. Liefert das LLM keine, filtern wir das per Post-Processing heraus (siehe Code oben).
- Self-Consistency: Bei kritischen Antworten läuft die Generation mit 3 unterschiedlichen Seeds; bei Abweichungen informieren wir den Nutzer oder übergeben an einen Human-Handoff.
Die drei Layer heben zusammen die Precision in einer mittelgroßen Domäne von einer Baseline von 60–70 % auf 92–95 % — gemessen anhand des Eval-Sets.
Eval-Pipeline — das Rückgrat des Projekts
Ohne Eval läuft die RAG-Pipeline blind. Nötig sind mindestens 50, idealerweise 100–200 manuell gelabelte Frage-Antwort-Paare:
eval_dataset = [
    {
        "question": "Was steht im Liefer-SLA von 2024 zum Q4-Schwellenwert für die Abwanderungsquote?",
        "expected_answer_keywords": ["Q4", "Abwanderungsquote", "8%"],
        "expected_chunks": ["doc_42_chunk_3", "doc_42_chunk_4"],
    },
    # ... 100+ weitere
]

def eval_run(rag_pipeline, dataset):
    results = []
    for case in dataset:
        response, retrieved_chunks = rag_pipeline.answer(case["question"])
        keyword_hit = all(kw in response for kw in case["expected_answer_keywords"])
        chunk_hit = any(
            c["id"] in retrieved_chunks for c in case["expected_chunks"]
        )
        results.append({
            "question": case["question"],
            "keyword_pass": keyword_hit,
            "chunk_recall": chunk_hit,
        })
    return results
Das Eval-Set läuft in der CI bei jeder Prompt- oder Config-Änderung. Liegt die Precision unter 90 % (oder dem projektspezifischen Ziel), wird das Deployment blockiert.
Hinweis: Auch das Eval-Set selbst braucht Pflege. Wir erweitern es anhand neuer Use Cases, Edge Cases und Nutzer-Feedback. In der Discovery-Phase sammeln wir gemeinsam mit dem Partner-Team 50–100 echte Fragen und labeln diese.
Deployment-Stack — zwei Richtungen
Vercel / Cloud-managed (Standard)
Für die meisten Projekte empfehlen wir dies:
- Frontend / API: Next.js auf Vercel
- Vector DB: Supabase pgvector (EU-Region)
- Embedding: OpenAI text-embedding-3-small
- LLM: OpenAI GPT-4o oder Anthropic Claude Sonnet
- Monitoring: Sentry + PostHog
- Cache: Vercel KV (Semantic Cache, 24h TTL)
Setup-Zeit: 1–2 Wochen bis zum MVP. Monatliche Kosten: $50–200 bei KMU-typischem Traffic.
Self-hosted (DSGVO-Priorität)
In datensensiblen Domänen:
- Frontend / API: Next.js Docker, internes Kubernetes
- Vector DB: Postgres + pgvector, on-prem
- Embedding: Ollama +
intfloat/multilingual-e5-large auf GPU-Instanz
- LLM: Ollama + Llama 3.3 70B (oder Qwen 2.5 72B, gut für ungarischsprachige Inhalte)
- Monitoring: Sentry self-hosted + Prometheus + Grafana
Setup-Zeit: 3–6 Wochen. Monatliche Kosten: $300–800 (GPU-Instanz + Ops). Es fallen keine Token-Kosten an, dafür Infrastrukturkosten.
Kostenschätzung — 50.000 Dokumente, 200 Queries/Tag
| Posten |
Cloud (managed) |
Self-hosted |
| Embedding-Ingestion (50k × einmalig) |
$10 |
$0 + 2–4 Std. Laufzeit |
| Embedding-Query (200/Tag × 30) |
$5 |
$0 + GPU |
| LLM-Generation (GPT-4o, ~1500 Token im Schnitt) |
$120 |
$0 + GPU |
| Vector-DB-Hosting |
$25 (Supabase Pro) |
$0 + Postgres-VM |
| Reranking (Cohere, 200/Tag) |
$6 |
$0 + BGE-GPU |
| Frontend-/API-Hosting |
$0 (Vercel Free) |
$20 VM |
| GPU-Instanz (self-hosted LLM, A100 24/7) |
n/a |
$400–700 |
| Monitoring |
$0 (Free Tier) |
$25 (self-hosted Alert Manager) |
| Monatlich gesamt |
~$166 |
~$445–770 |
Bei geringem Traffic zeigt die Self-hosted-Option ein schlechteres Kostenverhältnis, aber ab >1.000 Queries/Tag übersteigen die LLM-Token-Kosten die GPU-Kosten. Ab diesem Punkt ist Self-hosted wirtschaftlicher.
Kostenoptimierung — Semantic Cache
Fragen viele Nutzer Ähnliches („wie lautet die Urlaubsregelung?", „wie viele Urlaubstage habe ich?"), lohnt sich ein Semantic-Cache-Layer. Die eingehende Frage wird embedded, und findet sich im Cache eine frühere Query mit 0,9+ Cosine-Similarity, wird die gecachte Antwort zurückgegeben.
def get_cached_response(query: str, threshold: float = 0.9):
    query_emb = embed(query)
    closest = cache_db.search(query_emb, top_k=1)
    if closest and closest[0]["similarity"] > threshold:
        return closest[0]["response"]
    return None
Typische Cache-Hit-Rate: 25–40 % in Domänen mit vielen Wiederholungen. Das bedeutet eine Netto-Reduktion der Token-Kosten von 25–40 %.
Prompt Caching — Rabatt auf Provider-Ebene
Die APIs von OpenAI und Anthropic haben 2024–2025 Prompt Caching eingeführt. Der wiederkehrende System-Prompt wird mit 50–90 % Rabatt abgerechnet. Das läuft automatisch — achten Sie nur darauf, den System-Prompt nicht bei jeder Query zu ändern.
Monitoring und Observability
Für ein RAG-System auf Produktionsniveau braucht es Monitoring in drei Dimensionen:
- Latenz: p50, p95, p99 für den gesamten Round-Trip. Ziel: p95 < 3 s, p99 < 5 s.
- Kosten: Token-Verbrauch pro Query, täglich und monatlich, aufgeschlüsselt nach Modell.
- Qualität: Eval-Set-Genauigkeit bei jedem Release (automatisierte CI). Zusätzlich das Sammeln von Nutzer-Feedback (Daumen hoch / runter).
import sentry_sdk
from posthog import Posthog

posthog = Posthog(api_key="...", host="https://eu.posthog.com")

def track_rag_event(user_id, query, response, latency_ms, tokens, cost):
    posthog.capture(
        distinct_id=user_id,
        event="rag_query",
        properties={
            "query_length": len(query),
            "response_length": len(response),
            "latency_ms": latency_ms,
            "input_tokens": tokens["input"],
            "output_tokens": tokens["output"],
            "cost_usd": cost,
            "has_citations": "[chunk_" in response,
        },
    )
Analysieren Sie die Nutzerfragen, erkennen Sie, welche Dokument-Ausschnitte fehlen: Der Top-k-Similarity-Score ist niedrig, oder der Nutzer bewertet negativ. Diese Lücken sind die Inputs für den nächsten Ingestion-Batch.
Weiterführende Lektüre: das OpenAI-Evals-Repository und das Ragas-Framework — Letzteres liefert speziell RAG-spezifische Metriken (Faithfulness, Answer Relevancy, Context Precision).
Wann brauchen Sie KEIN RAG?
Einige Fälle, in denen RAG Over-Engineering ist:
- <100 Dokumente, ändern sich selten. Einfacher ist es, alles direkt in den Long-Context-Prompt zu packen (Claude 200K).
- Die Nutzerfrage ist stark strukturiert. Z. B. „Preis von Produkt X?" — hier ist eine SQL-Query auf die Katalog-DB besser.
- Die Antwort muss kreativ sein. Marketingtexte, Ideenfindung — hier bremst die Quellenbindung.
- Echtzeit-Streaming-Feed. News, Social Media — die Embedding-Pipeline ist zu langsam; nutzen Sie stattdessen LLM + Web-Search-Tool-Calling.
Fazit
RAG ist 2026 keine Raketenwissenschaft — ein funktionierender Prototyp entsteht in einer Woche. Der schwierige Teil ist die Pflege des Eval-Sets, die Abdeckung von Edge Cases und das Kostenmonitoring. Wenn Sie es ernsthaft einsetzen wollen, planen Sie ein 8-12-wöchiges Projekt entlang der Kette Discovery → PoC → MVP → Produktion:
- Woche 1–2: Discovery, Audit des Dokument-Corpus, Aufbau des Eval-Sets (50–100 Fälle).
- Woche 3–4: PoC — grundlegende Ingestion + Retrieval + Generation, gemessen am Eval-Set.
- Woche 5–7: MVP — Hybrid Search, Reranking, Citation, Monitoring.
- Woche 8–10: Hyper-Care — iteratives Feintuning im echten Betrieb, Erweiterung des Eval-Sets.
- Woche 11–12: Übergabe, Dokumentation, Support-Runbook.
Die Gesamtkosten (Build + 3 Monate Hyper-Care) liegen im KMU-Maßstab bei 2,5–5 Millionen HUF. Der monatliche Betrieb ($150–700) kommt danach hinzu.
Wenn Sie ein KI-Projekt planen, sprechen wir in einem 30-minütigen Gespräch darüber. Nach der Discovery liefern wir einen konkreten Scope und eine Festpreiskalkulation. Weiterführende Lektüre: die Case Study zum Lead-Assistenten liefert Erkenntnisse aus einem konkreten Live-Projekt, der Artikel KI-Implementierung bei ungarischen KMU behandelt die KMU-spezifische ROI-Berechnung.