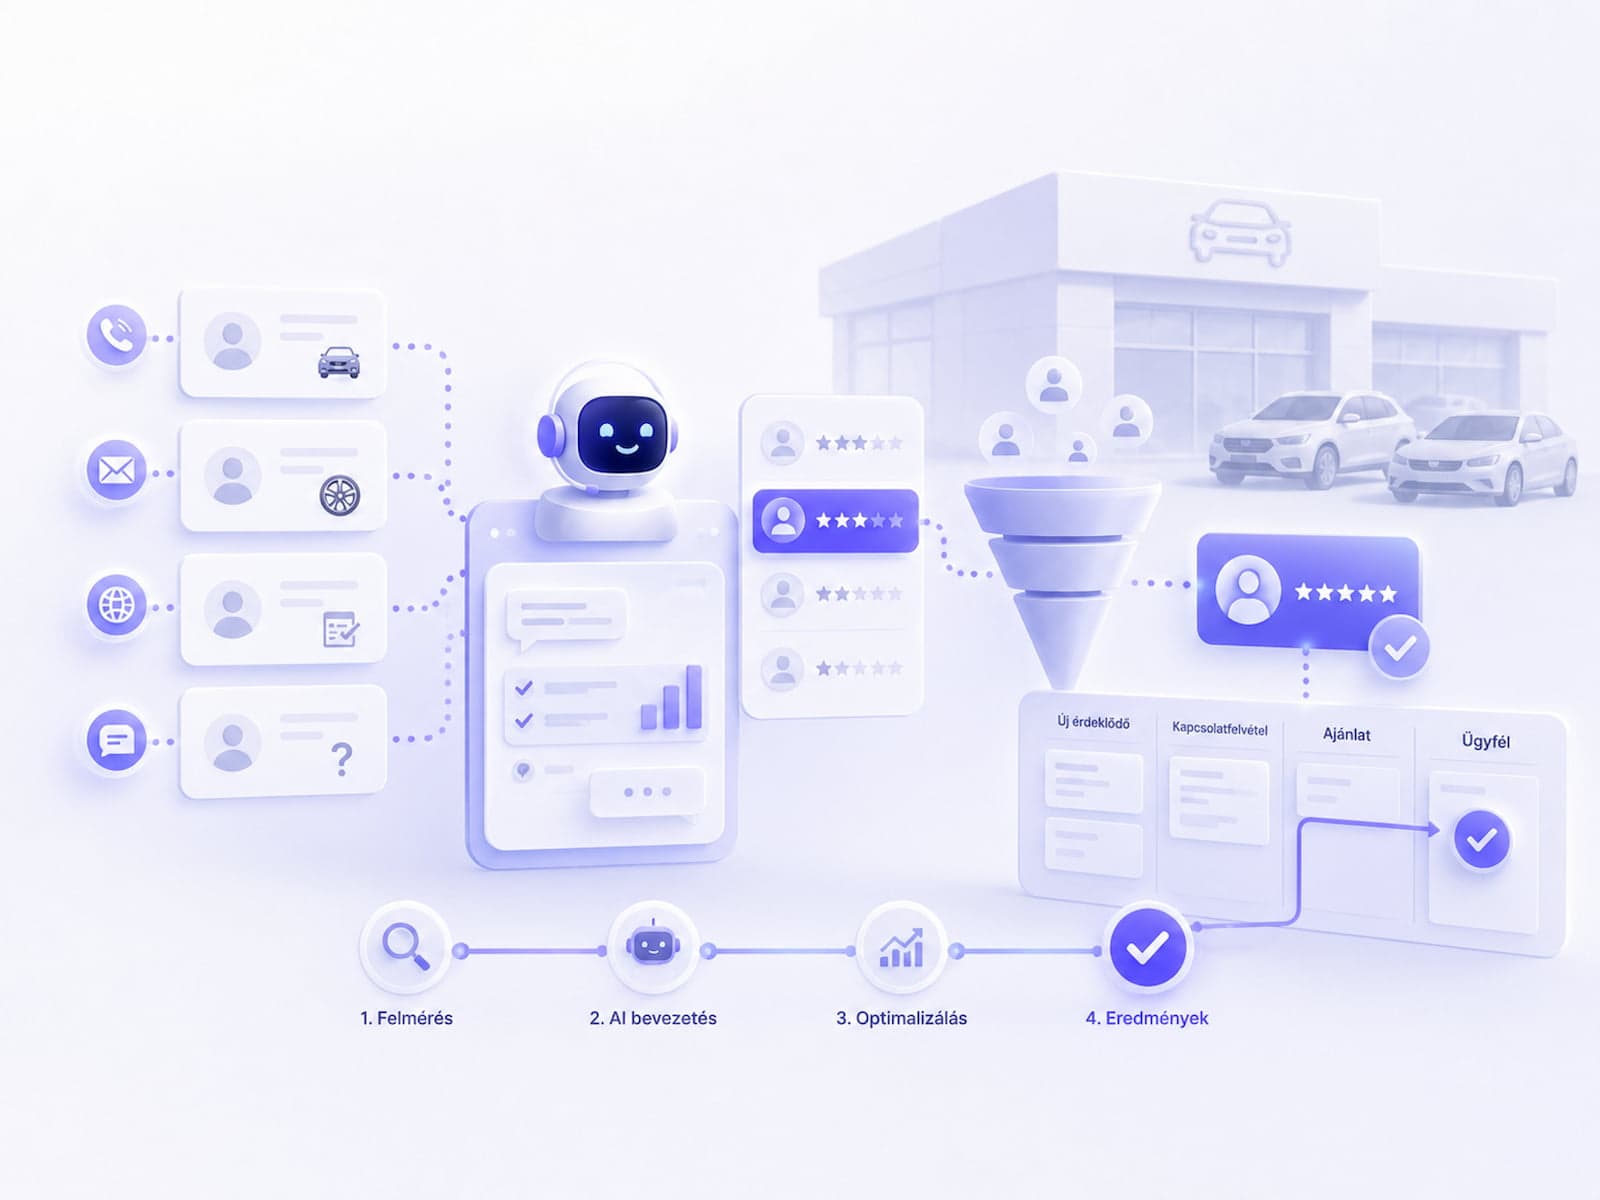
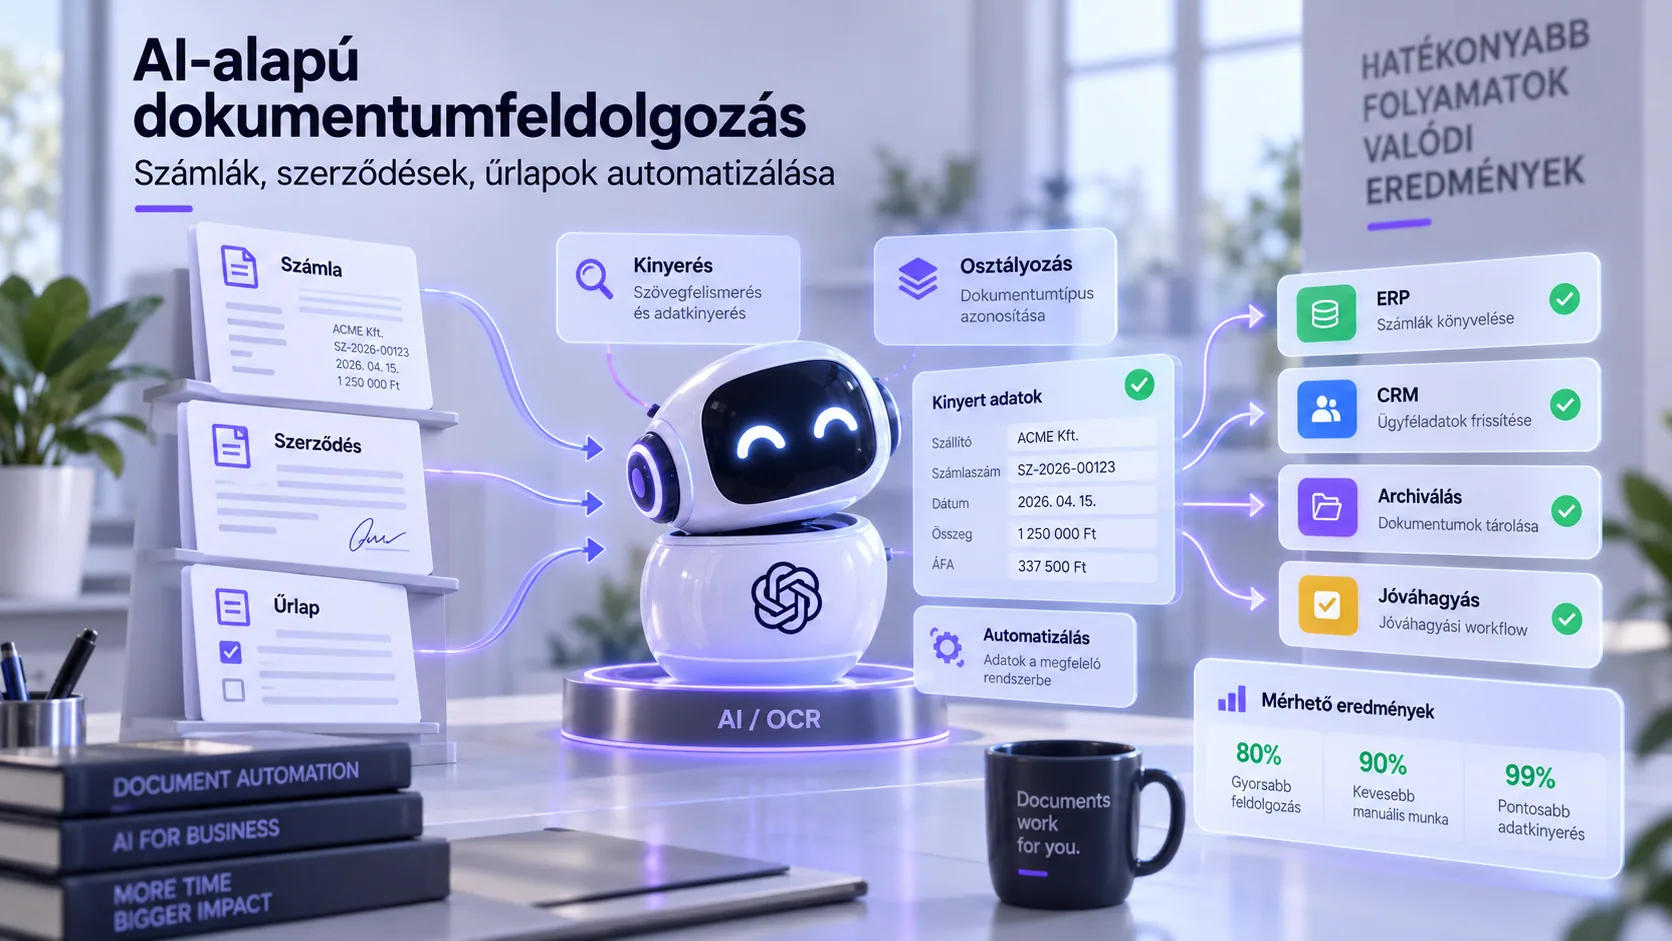
Die vollständige Architektur besteht aus 7 Hauptkomponenten:
- Next.js-Frontend (auf Vercel) — Ungarisch/Englisch, ISR.
- WooCommerce-Backend (DigitalOcean Droplet) — Katalog, Lagerbestand.
- n8n self-hosted (DigitalOcean Droplet, Docker) — Orchestrierung.
- OpenAI API — Klassifizierung und Erstellung des Follow-up-Entwurfs.
- HubSpot CRM — Lead-Ingestion in 4 Pipelines.
- Twilio — SMS-Trigger bei hoher Dringlichkeit.
- Audit-Log (Postgres) — Ergebnis jeder Klassifizierung, zu Eval-Zwecken.
Technikentscheidungen — warum wir was gewählt haben
n8n vs. Zapier vs. Make
Die Plattformwahl erfolgte in der 2. Woche der Discovery-Phase. Wir haben alle drei evaluiert:
| Kriterium |
Zapier |
Make |
n8n self-hosted |
| Datenresidenz (DSGVO) |
Enterprise |
EU-Host-Option |
Volle Kontrolle |
| Git-Versionierung des Workflows |
Nein |
Nein |
Ja |
| Monatliche Kosten bei 100k Events |
389 $ |
99 $ |
20 $ (VPS) |
| Setup-Zeit |
2 Tage |
3 Tage |
5 Tage |
| Team-Skill (bei uns) |
Mittel |
Mittel |
Hoch |
n8n self-hosted setzte sich durch, weil (1) auf dem eigenen DigitalOcean-VPS bereits eine andere Integration lief — die Kapazität ließ sich teilen, (2) sich das Workflow-JSON in Git versionieren ließ, was wegen der Prompt-Iterationen wichtig war, (3) es aus DSGVO-Sicht sauberer ist (personenbezogene Daten verlassen niemals den eigenen Server), (4) es langfristig günstiger ist.
Ausführlicher Plattformvergleich: n8n vs. Zapier vs. Make 2026.
OpenAI GPT-4o vs. Anthropic Claude Sonnet
Bei der Eval-Messung in Woche 4:
| Metrik |
GPT-4o |
Claude Sonnet 4 |
| Genauigkeit auf dem Eval-Set (60 Fälle) |
94 % |
91 % |
| Sprachqualität auf Ungarisch |
Gut |
Gut |
| Kosten / 1M Input-Token |
2,5 $ |
3,0 $ |
| Strenge des JSON-Modus |
Ausgezeichnet |
Gut (Tool Use) |
| Latenz p95 |
1,8 s |
2,2 s |
OpenAI gewann mit knappem Vorsprung. Bei ungarischsprachigen Lead-Texten lieferte es eine etwas höhere Genauigkeit, und der JSON-Modus war strenger als Claudes Tool Use. Claude blieb als Alternative in der Fallback-Logik erhalten — antwortet OpenAI mit 503, schaltet das System automatisch auf Claude um.
Tipp: Für die ungarische Sprache gibt es kein eindeutig am besten geeignetes Modell. Testen Sie es mit einem eigenen Eval-Set. Das Eval-Set sollte aus 50-100 echten Lead-Texten mit kategorischen Labels bestehen — das ist ein Tagesaufwand, und danach wissen Sie genau, welches Modell in Ihrer Domäne besser abschneidet.
WooCommerce-Katalog — warum haben wir ihn nicht ersetzt?
Im ersten Call schlug der Geschäftsführer vor, „etwas Moderneres statt WooCommerce" einzusetzen. Wir hielten dagegen: Der WooCommerce-Katalog ist das tägliche Arbeitswerkzeug des Back-Office-Teams (3 Personen), das seit Jahren damit vertraut ist. Die Umstellung hätte bedeutet:
- 6-8 Wochen außerhalb des Scopes.
- Weitere 2-3 Wochen Schulung für die 3 Mitarbeitenden.
- Migrationsrisiko (über 1.500 Produkte, über 8.000 Produktvarianten).
Innerhalb des Scopes blieb WooCommerce bestehen, und die Aufstellung Next.js als Frontend, WooCommerce als Backend funktionierte gut. Die REST-API von WooCommerce ist gut (das begrenzte Rate-Limit war die einzige Herausforderung, siehe weiter unten).
Größe des Eval-Sets
Aus den 800 in der Discovery-Phase gesammelten Lead-E-Mails wählten wir 60 für das Eval-Set aus. Zufällig ausgewählt und über die 4 Kategorien balanciert (15-15-15-15). Bei jedem Push (der Prompt liegt im Git-Repository) lief das Eval-Set automatisch durch — fiel die Genauigkeit unter 92 %, wurde das Deployment blockiert.
Die Größe von 60 ist ein Kompromiss. Ein kleineres Set (30-40) liefert eine schwächere statistische Signifikanz, ein größeres (100+) erfordert mehr Discovery-Zeit und Pflegeaufwand. Als projektweites Minimum setzten wir 50 an.
Implementierung Schritt für Schritt
Die Workflow-Logik ist einfacher, als sie klingt:
# n8n-Workflow (vereinfacht, 14 Nodes)
1. Webhook-Trigger (n8n)
   ↓
2. Input-Validierung (E-Mail-Format, Pflichtfelder, Längenprüfung)
   ↓
3. Honeypot-Check (Spam-Filter — verstecktes Feld darf nicht ausgefüllt sein)
   ↓
4. Rate-Limit-Check (Redis-Cache: max. 5 Übermittlungen / IP / Stunde)
   ↓
5. OpenAI-Aufruf (GPT-4o)
   - System-Prompt: "Du bist ein Lead-Klassifizierer..."
   - User-Prompt: Formularinhalt + Produktkontext
   - Response-Format: JSON (category, urgency, follow_up_draft)
   - Temperature: 0,2 (niedrig für Klassifizierung)
   ↓
6. JSON-Validierung (Pydantic-Schema)
   ↓
7. Confidence-Check:
   - urgency ≥ 80 → SMS-Trigger (Twilio-Webhook)
   - urgency < 50 → Human-Review-Warteschlange
   ↓
8. HubSpot-Pipeline-Routing:
   - "technical" → Werkstatt-Pipeline
   - "commercial" → Flotten-Pipeline
   - "complaint" → Reklamations-Pipeline
   - "partnership" → Partner-Pipeline
   ↓
9. HubSpot: Deal erstellen + Kontakt erstellen
   ↓
10. Follow-up-E-Mail-Entwurf an den Sales-Mitarbeiter senden (NICHT automatisch an den Lead)
    ↓
11. Audit-Log: Postgres-Insert (Input, Output, Modell, Latenz, Kosten, Dringlichkeit)
    ↓
12. PostHog-Event-Tracking
    ↓
13. Fehlerbehandlung (Sentry bei jedem 5xx, Fallback auf Claude bei OpenAI-503)
    ↓
14. Webhook-Response 200 OK
Der vollständige Workflow besteht aus 14 Nodes. Der Prompt ist im Git-Repository versioniert, und das Eval-Set läuft bei jedem Push automatisch durch.
Der System-Prompt — der kritische Teil
Du bist eine KI zur Lead-Klassifizierung für einen B2B-Ersatzteilzulieferer
in der Automobilbranche. Eingehende Nachrichten musst du in 4 Kategorien
einordnen und ihnen einen Dringlichkeits-Score geben (0-100).

KATEGORIEN:
- technical: Teile-Passung, Kompatibilität, technische Frage
- commercial: Preis, Rabatt, Lagerbestandsanfrage, Angebotsanfrage
- complaint: Rückerstattung, Umtausch, Garantieanspruch, Reklamation
- partnership: Zulieferer-, Wiederverkäufer-, Kooperationsangebot

URGENCY-SCORING:
- 90-100: konkrete Kaufabsicht, dringender Zeitrahmen ("wird heute benötigt")
- 70-89: aktives Interesse, Entscheidungszyklus von 1-3 Tagen
- 50-69: allgemeine Frage, längerer Zyklus
- 30-49: Informationsanfrage, geringe Kaufabsicht
- 0-29: Spam, themenfremd, irrelevant

FORMAT (JSON):
{
  "category": "technical" | "commercial" | "complaint" | "partnership",
  "urgency": 0-100,
  "confidence": 0-100,
  "follow_up_draft": "Antwortentwurf mit 200-400 Zeichen, auf Ungarisch",
  "reasoning": "Ein bis zwei Sätze Begründung für die Kategorisierung"
}

FEW-SHOT-BEISPIELE:

BEISPIEL 1:
Input: "Guten Tag, für den Motorblock ABC-123 suchen wir das Ersatzteil
       PQR-456. Wir bräuchten es morgen früh um 8 Uhr. Können Sie heute
       noch liefern?"
Output: {"category": "technical", "urgency": 92, "confidence": 90, ...}

BEISPIEL 2:
Input: "Guten Tag, ich hätte gern ein Angebot für 50 Stück des Filters
       DEF-789, für unsere Flotte. Wie hoch ist der Mengenrabatt?"
Output: {"category": "commercial", "urgency": 75, "confidence": 95, ...}

[... weitere 8 Beispiele, 2-3 / Kategorie ...]

Klassifiziere nun das Folgende:
INPUT: {user_form_content}
PRODUCT CONTEXT: {product_metadata}
Der Prompt enthielt am Ende 8 Few-Shot-Beispiele (2 pro Kategorie). Mit den anfänglichen 4 Beispielen erreichten wir eine Eval-Genauigkeit von 89 %, mit den 8 Beispielen 94 %.
Testing und Prompt-Engineering-Iterationen
Der Prompt stand nicht auf Anhieb. In der Discovery- und Build-Phase gab es 5 Iterationen:
Iteration 1 — Basisprompt (Woche 5)
Einfacher Prompt mit 4 Beispielen. Eval-Genauigkeit: 78 %. Hauptfehler:
- Grenzfall technisch/kommerziell: „Was kostet das Ersatzteil ABC-123?" — technical oder commercial?
- Reklamation vs. technisch: „Das Teil X habe ich vor 2 Wochen gekauft, und es passt nicht" — Reklamation oder technische Frage?
Iteration 2 — Verfeinerung der Kategoriedefinitionen (Woche 6)
Präzisere Definitionen im System-Prompt, plus 2 neue Few-Shot-Beispiele für die Grenzfälle. Eval-Genauigkeit: 86 %.
Iteration 3 — Neugestaltung des Urgency-Scorings (Woche 7)
Die anfängliche Urgency-Skala (niedrig/mittel/hoch) war zu grob. Wir stellten auf einen 0-100-Score mit detaillierten Beispielen um. Eval-Genauigkeit: 90 % (die Urgency-Messung war aber noch ungenau).
Iteration 4 — Ergänzung von Confidence und Reasoning (Woche 8)
Das Modell lieferte nun explizit einen Confidence-Wert und eine Begründung. Das brachte zwei Effekte: (1) Fälle mit niedriger Confidence werden automatisch für die Human-Review markiert, (2) das Debugging geht deutlich schneller (die Begründung zeigt, warum eine Fehleinschätzung passierte).
Eval-Genauigkeit: 92 %.
Iteration 5 — Erweiterung auf 8 Beispiele + Produktkontext (Woche 9)
8 Few-Shot-Beispiele, 2 pro Kategorie, plus der Produktkontext (Artikelnummer, Kategorie) im Prompt ergänzt. Eval-Genauigkeit: 94 %.
Tipp: Prompt-Feinabstimmung verläuft nicht linear. Von Iteration 1 bis 4 gab es bei jedem Schritt Überraschungen — der „klügere" Prompt hat den Wert oft verschlechtert. Ohne Eval-Set hätten wir das nicht gemessen.
Regressionstests
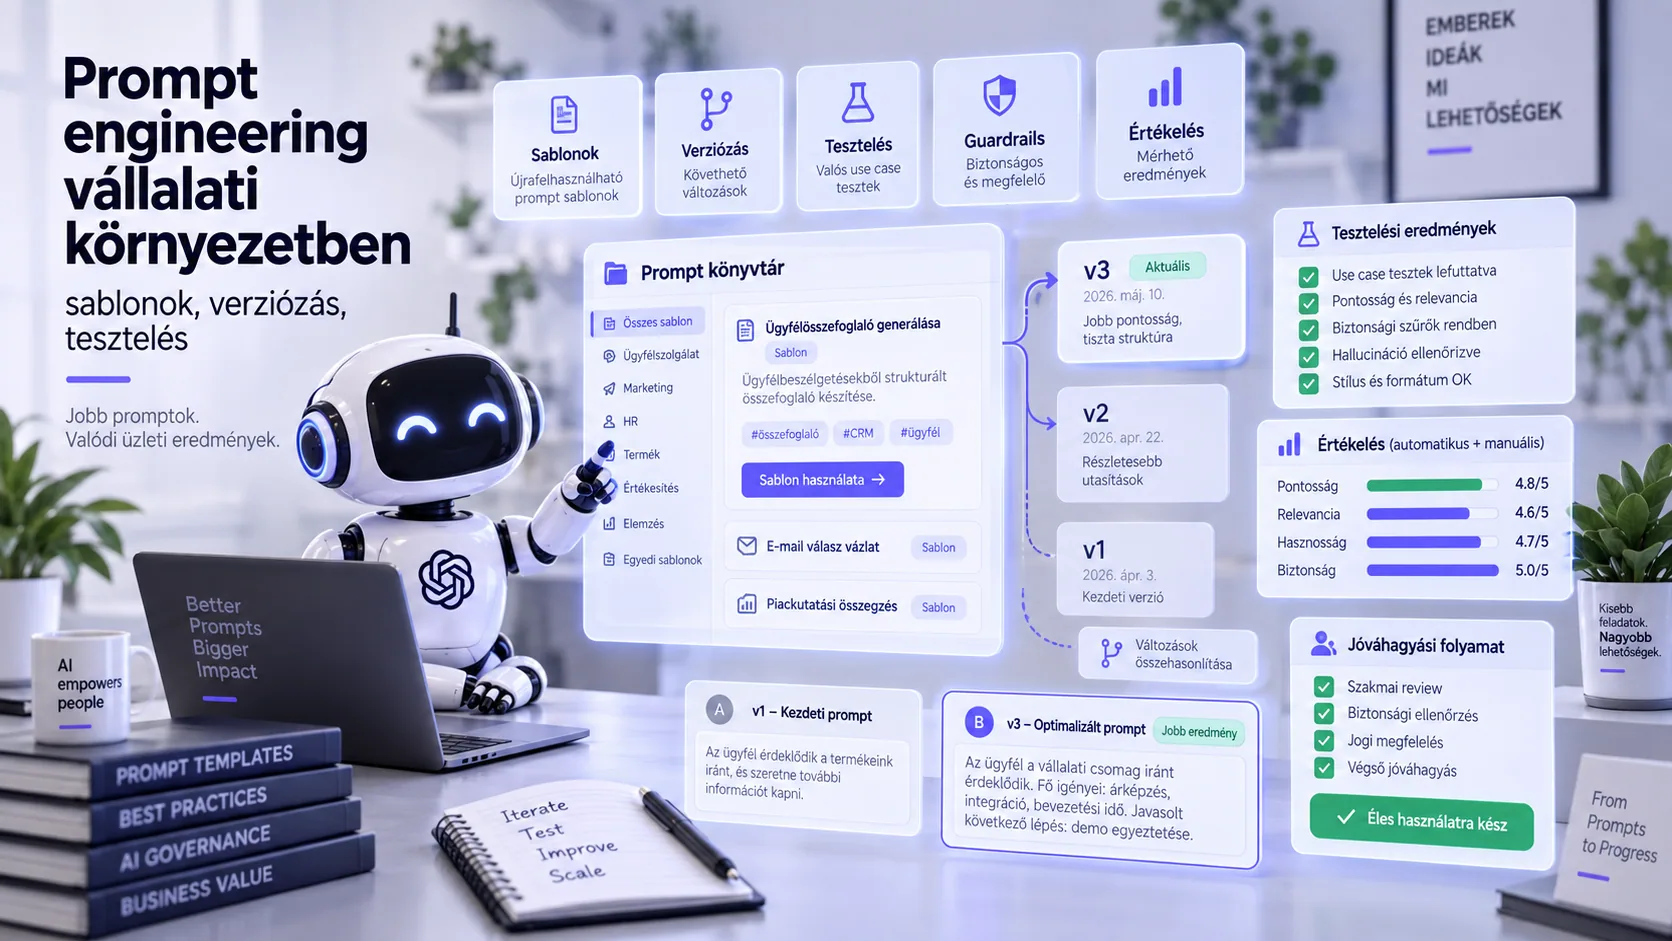
Bei jedem Push (Git-Commit auf das Prompt-JSON) lief das 60-elementige Eval-Set in einer GitHub Action durch. Fiel die Genauigkeit unter 92 %, wurde der PR blockiert. Diesen Schwellenwert setzten wir später auf 90 % herab, weil 92 % durch neue Grenzfälle zu streng geworden war.
Der Zeitplan der 4 Monate
| Woche |
Phase |
Output |
| 1-3 |
Discovery |
Prozess-Mapping, Eval-Set, Scope-Dokument, Baseline-Messung |
| 4-5 |
Design |
Frontend-Figma, Entwurf des n8n-Workflows, Prompt v1 + Few-Shot-Beispiele |
| 6-9 |
Build |
Next.js-Entwicklung, n8n-Workflow, OpenAI-Integration, Prompt-Iterationen 1-5 |
| 10-11 |
Interner Test |
Eval-Set-Genauigkeit 94 %, UAT-Feedback des Sales-Teams |
| 12 |
Soft Launch |
Nur die technische Fragekategorie live, 1 Woche Monitoring |
| 13 |
Full Launch |
Alle 4 Kategorien, Dashboard für den Vertrieb |
| 14-17 |
Hyper-Care |
Wöchentliches Monitoring, Prompt-Feinabstimmung, Aufnahme von Grenzfällen ins Eval-Set |
Herausforderungen — was wir anders gemacht hätten
1. Das Sales-Team vertraute der KI-Klassifizierung anfangs nicht
Problem: In den ersten 2 Wochen schlug der Workflow nur eine Kategorie vor, der Sales-Assistent prüfte sie aber manuell. Erst nach 80 Leads, als die Genauigkeit stabil bei 94 % lag, begann das Team, die Klassifizierung automatisch zu übernehmen.
Der Geschäftsführer fragte anfangs: „Und wenn falsch kategorisiert wird? Wenn eine Reklamation als commercial landet?" — eine berechtigte Sorge. In der Automobilbranche ist eine falsch gehandhabte Reklamation ein Reputationsrisiko auf Markenebene.
Lösung: In den ersten 2 Wochen tat das System 4 Dinge: (1) es klassifizierte, (2) es schlug einen Follow-up-Entwurf vor, (3) es trug den Lead NICHT ins CRM ein, sondern schickte ihn nur als Slack-Nachricht an den Sales-Assistenten, (4) der Assistent validierte manuell. Nach 80 Leads gab die Sales-Leitung die automatische CRM-Ingestion frei.
Lehre: Vertrauensaufbau ist bei KI-Projekten wichtiger als die Technik. Eine 2-wöchige manuelle Verifizierungsphase vor dem Soft Launch lohnt sich — und sollte fest ins Budget eingeplant werden.
2. WooCommerce-API-Rate-Limit
Problem: In Spitzenzeiten (morgens 9-10 Uhr, nachmittags 14-15 Uhr) erreichten die 60-90 Produktseiten-Requests den Woo-Throttle. Das Standard-Rate-Limit von WooCommerce liegt bei ca. 50 Requests / Minute, und in Spitzenzeiten überschritten wir das schlicht.
Lösung: Vercel-KV-Cache mit einer TTL von 10 Minuten. Für B2B-Käufer ist der Echtzeit-Lagerbestand nicht kritisch — 10 Minuten Verzögerung sind akzeptabel. Der Cache erreichte in Spitzenzeiten eine Hit-Rate von 95 %.
// Vereinfachte Cache-Logik
async function getProductData(sku: string) {
  const cached = await kv.get(`product:${sku}`);
  if (cached) return cached;
  const data = await wooCommerceApi.fetch(sku);
  await kv.set(`product:${sku}`, data, { ex: 600 }); // 10 Minuten
  return data;
}
Lehre: Rate-Limit-Tests gehören in die Discovery-Phase, nicht in die Hyper-Care nach dem Launch. Wenn ich es heute wüsste, würde ich in der ersten Woche einen Lasttest fahren.
3. Feinabstimmung des ungarischsprachigen Prompts
Problem: OpenAI GPT-4o beherrscht Ungarisch gut, aber die Few-Shot-Beispiele mussten im osteuropäischen Geschäftskontext formuliert werden. Das Wort „Preisangebot" kann je nach Kontext beispielsweise sowohl technisch als auch kommerziell eingeordnet werden. „Bitte um technische Infos" kann eine einfache Frage sein (technical), aber auch der Beginn eines konkreten Beschaffungsinteresses (commercial).
Lösung: mindestens 2 Few-Shot-Beispiele pro Kategorie (insgesamt 8), aus echten Fällen des 800er-Discovery-Archivs. Jedes Beispiel auf Ungarisch, mit typischem ungarischem Fachjargon aus der Automobilbranche.
Lehre: mindestens 3-5 echte Few-Shot-Beispiele pro Kategorie (nach Möglichkeit mehr). Das zugehörige Eval-Set sollte nicht unter 60 Elemente fallen.
4. Gefahr von SMS-Spam
Problem: In den ersten Wochen lag die Urgency-Schwelle bei 70. Das bedeutete, dass der Sales-Assistent täglich 8-12 SMS erhielt. Nach dem 3. Tag meldete er, das sei „nicht ideal".
Lösung: Die Schwelle wurde auf 80 angehoben, plus eine Regel „SMS nur werktags zwischen 8 und 18 Uhr" im n8n-Workflow. Am Wochenende und nachts wird hohe Dringlichkeit nur per E-Mail markiert.
Lehre: Beim Entwurf eines Benachrichtigungs-Flows sollte man den Stresslevel des Empfängers bedenken, nicht nur den ROI des Absenders.
5. Rotation der HubSpot-Pipelines
Problem: Die 4 Pipelines für die 4 Kategorien sind logisch, aber das Sales-Team stellte fest, dass ein „kommerzielles Interesse" oft zu einer „Reklamation" wurde, wenn der Flottenbetreiber nicht schnell genug eine Antwort erhielt. Die Pipeline-Rotation war unflexibel.
Lösung: Eine manuelle Override-Schaltfläche in der HubSpot-UI. Ein Deal kann jederzeit in eine andere Pipeline verschoben werden, n8n schreibt das nicht automatisch zurück.
Lehre: Ein KI-System sollte nicht eigenmächtig handeln. Eine Human-Override-Option ist Pflicht.
Ergebnisse — nach 3 Monaten
| Metrik |
Baseline |
Nach 90 Tagen |
| Lead-Response-Zeit (Median) |
18 Stunden |
4 Stunden |
| Anteil Antworten unter 90 Minuten |
12 % |
41 % |
| Antwort innerhalb von 24 Stunden |
53 % |
89 % |
| Tägliche E-Mail-Triage im Sales |
35-40 Minuten |
5 Minuten |
| Genauigkeit des Eval-Sets |
n/a |
94 % |
| Mobiler LCP des Webshops |
4,2 s |
1,6 s |
| Organischer Suchtraffic |
Baseline |
+22 % |
| High-Urgency-SMS-Aktionen |
n/a |
8-12 / Woche |
Die Zahlen sind Näherungswerte, aber der Trend ist eindeutig. Das konkrete Geschäftsergebnis: Am Ende des 4. Monats wurden 3 Geschäfte abgeschlossen, die im alten Flow sicher verloren gegangen wären — in einem Segment mit einem auf schnelle Angebote spezialisierten Wettbewerber. Das ist eine konkrete Forint-Zahl, die der CFO bestätigt hat und die für sich genommen bereits rund 40 % der Projektkosten deckte.
Das Feedback des Geschäftsführers (nach Projektabschluss, mit Erlaubnis für dieses Case-Study-Zitat):
„Die klügste Entscheidung war, den gesamten Prozess nicht auf einmal ersetzen zu wollen. Wir konnten die kleinen Schritte messen, und das Team akzeptierte die KI-Einführung erst, als es mit eigenen Augen sah, dass sie funktioniert. Die 80 manuellen Validierungen während des Soft Launch wirkten anfangs abschreckend, im Nachhinein war das aber die wertvollste Investition."
Kostenaufstellung
| Posten |
Kosten |
| Discovery (3 Wochen, fix) |
600.000 HUF |
| Build (8 Wochen, fix) |
2.400.000 HUF |
| Hyper-Care (4 Wochen, enthalten) |
inklusive |
| OpenAI-API-Token-Kosten (monatlich 80-120.000 HUF) |
100.000 HUF / Monat |
| n8n-Self-Host-VPS (DigitalOcean) |
8.000 HUF / Monat |
| HubSpot Starter (bereits vorhanden) |
0 (bestehend) |
| Twilio SMS (ca. 500 SMS / Monat) |
15.000 HUF / Monat |
| Gesamte Build-Kosten |
3.000.000 HUF |
| Monatliche Betriebskosten |
~125.000 HUF |
ROI-Schätzung: Rückgewinn von 3 verlorenen Geschäften plus Zeitersparnis im Vertrieb = ein Wert von ca. 6-8 Mio. HUF / Jahr. Der ROI trat innerhalb von 12 Monaten ein.
Lessons Learned — 5 konkrete Punkte
1. Die Discovery-Dauer ist nicht fix
Die dreiwöchige Discovery-Phase wirkte lang, aber ohne die manuelle Kennzeichnung der 800 Elemente wäre sie nicht möglich gewesen. Das Eval-Set ist das Rückgrat des Projekts — und ohne manuelle Daten gibt es kein Eval-Set. Kürzen Sie die Discovery-Dauer nicht nur, weil der Kunde „schnell Ergebnisse sehen will".
2. Soft Launch in Etappen
Wir haben die 4 Kategorien nicht gleichzeitig live geschaltet. Zuerst ging technical (die einfachste) live, mit 1 Woche Monitoring, danach folgte commercial; complaint und partnership gingen erst in Woche 13 live. Das bedeutete 2 Wochen „Verlangsamung", senkte aber das Risiko dramatisch.
3. Pflege des Eval-Sets
Das 60-elementige Eval-Set passte am Launch-Tag, aber neue Grenzfälle kommen laufend hinzu. Während der Hyper-Care-Phase ergänzten wir wöchentlich 5-10 neue Fälle. In Woche 17 umfasste das Eval-Set 110 Elemente.
4. Buy-in des Sales-Teams ist nicht optional
Das KI-System ist nur dann wirksam, wenn das Sales-Team es nutzt und nicht ignoriert. Genau darum ging es in der manuellen Validierungsphase der ersten Wochen: Das Team sollte sich an den Flow gewöhnen, Vorschläge einbringen und das System mit einem Gefühl von Eigenverantwortung behandeln.
5. Cost-Monitoring von Tag eins an
Die Token-Kosten der OpenAI-API können leicht aus dem Ruder laufen. In der Tabelle audit_log erfassten wir die Kosten jeder Klassifizierung, und ein tägliches Dashboard zeigte sie an. Lag ein Tag über 5 $, gab es einen Alert. (Typische Tageskosten: 1-3 $.)
Offizielle Dokumentationen und weiterführende Lektüre
Verwandte eigene Artikel: Aufbau eines RAG-Chatbots — vertiefte Betrachtung von Vector-DB und LLM-Kontext. Schutz vor LLM-Halluzinationen — Confidence-Scoring- und Output-Validierungstechniken. KI-Implementierung bei ungarischen KMU — KMU-spezifische ROI-Berechnung.
Fazit
Der Erfolg eines KI-Projekts hängt nicht allein von der Genauigkeit des Modells ab, sondern von der Qualität der Discovery-Phase, der Einbindung des Sales-Teams und dem iterativen Launch. Die 94-prozentige Genauigkeit des Eval-Sets ist das Ziel, nicht der Ausgangspunkt.
Das gesamte Projekt dauerte 4 Monate, die Build-Kosten lagen bei 3 Mio. HUF. Der monatliche Betrieb kostet 125.000 HUF. Der ROI trat innerhalb von 12 Monaten ein — vor allem dank der 3 zurückgewonnenen Geschäfte und der Zeitersparnis im Vertrieb.
Wenn Sie einen KI-Lead-Assistenten planen, sprechen Sie mit uns in einem 30-minütigen Call. Die Discovery-Kosten (200.000-600.000 HUF) amortisieren sich typischerweise bereits im ersten Monat durch die eingesparten verlorenen Geschäfte — wenn das Problem real ist.