Die häufigste DSGVO-Frage, die wir vor einem LLM-Projekt hören, lautet: „Dürfen wir Kundendaten überhaupt an eine KI weitergeben?" Die Antwort lautet 2026: Ja, unter denselben Voraussetzungen wie bei jedem anderen Auftragsverarbeiter – nur wissen die meisten Unternehmen nicht, wo sie einen Teil dieser Voraussetzungen finden. Die zweithäufigste Frage lautet: „Reicht es, wenn wir die Daten anonymisieren?" Die Antwort darauf: Das hängt davon ab, was Sie unter Anonymisierung verstehen – in den meisten Fällen handelt es sich bei dem, was so genannt wird, tatsächlich um eine Pseudonymisierung, bei der es sich weiterhin um personenbezogene Daten handelt.
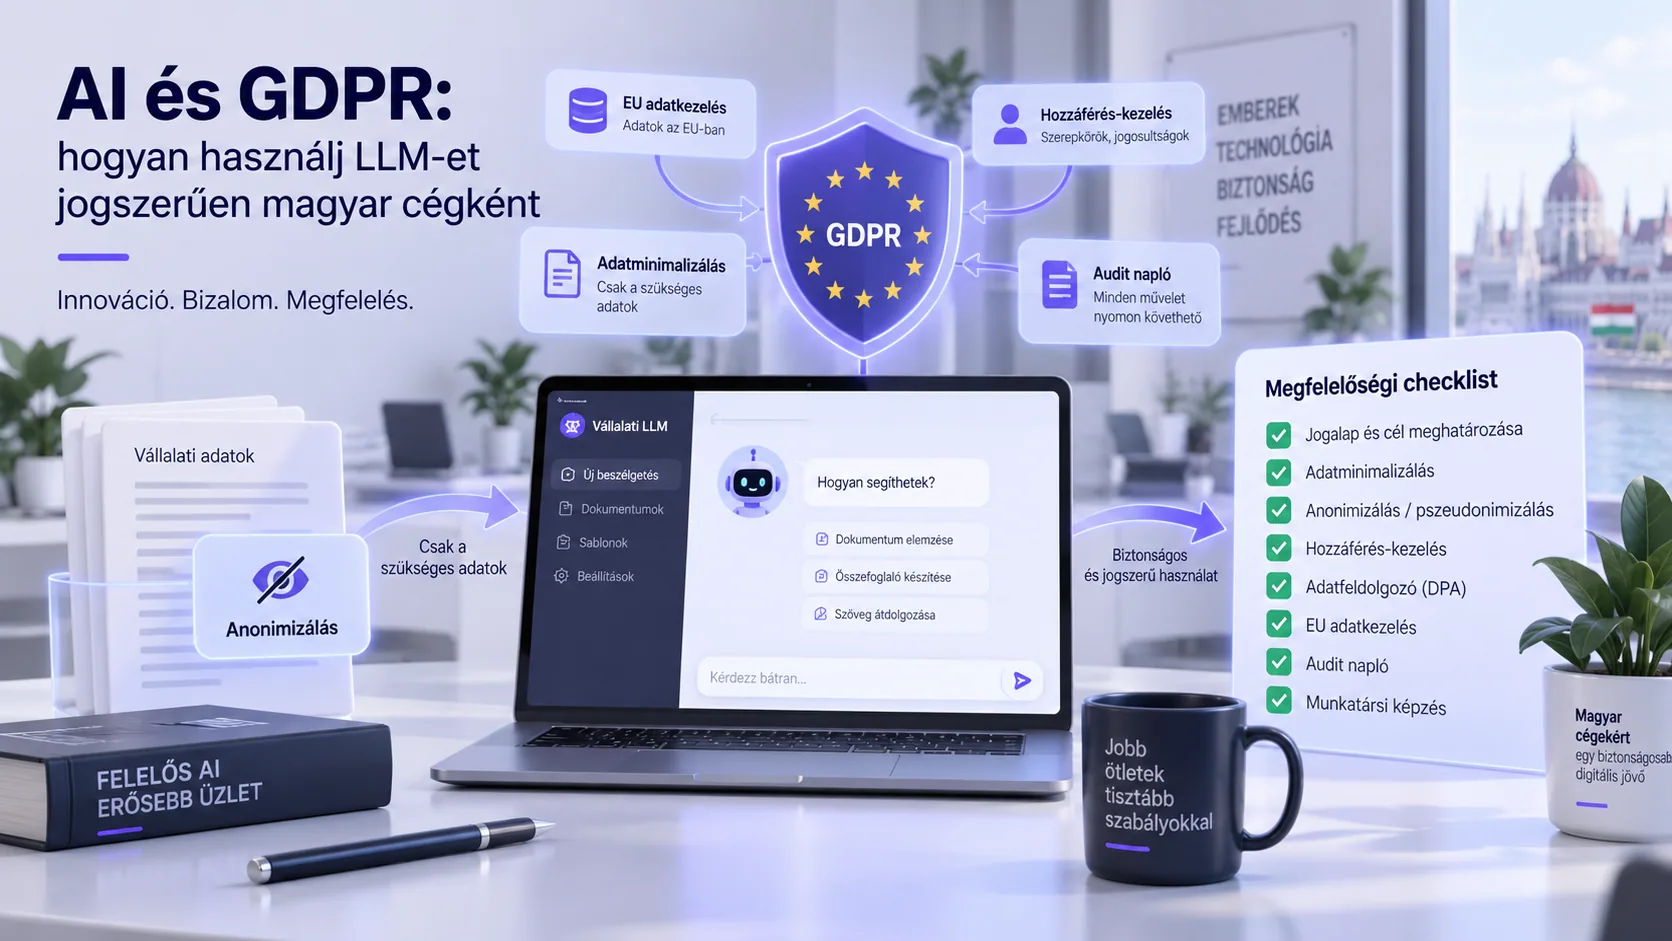
Dieser Artikel beschreibt die praktische Seite: auf welcher Rechtsgrundlage personenbezogene Daten an ein LLM gehen dürfen, was der Auftragsverarbeitungsvertrag mit dem KI-Anbieter enthalten muss, welche EU-Datenresidenz-Möglichkeiten die drei großen Anbieter bieten, wie eine Pseudonymisierungs-Pipeline im Code aussieht, wie es um Aufbewahrung und Nutzung zu Trainingszwecken steht, wie man einen Interessenabwägungstest schreibt und was der AI Act mit sich bringt. Am Ende steht eine Checkliste, die sich vor dem Projektstart durchgehen lässt.
Ein Satz zum Rahmen: Dieser Artikel beruht auf technischer und prozessbezogener Erfahrung, nicht auf Rechtsberatung; die rechtliche Bewertung der konkreten Datenverarbeitung obliegt dem Datenschutzbeauftragten oder der Rechtsabteilung des Unternehmens, und dieser Artikel unterstützt diese Arbeit, ersetzt sie aber nicht.
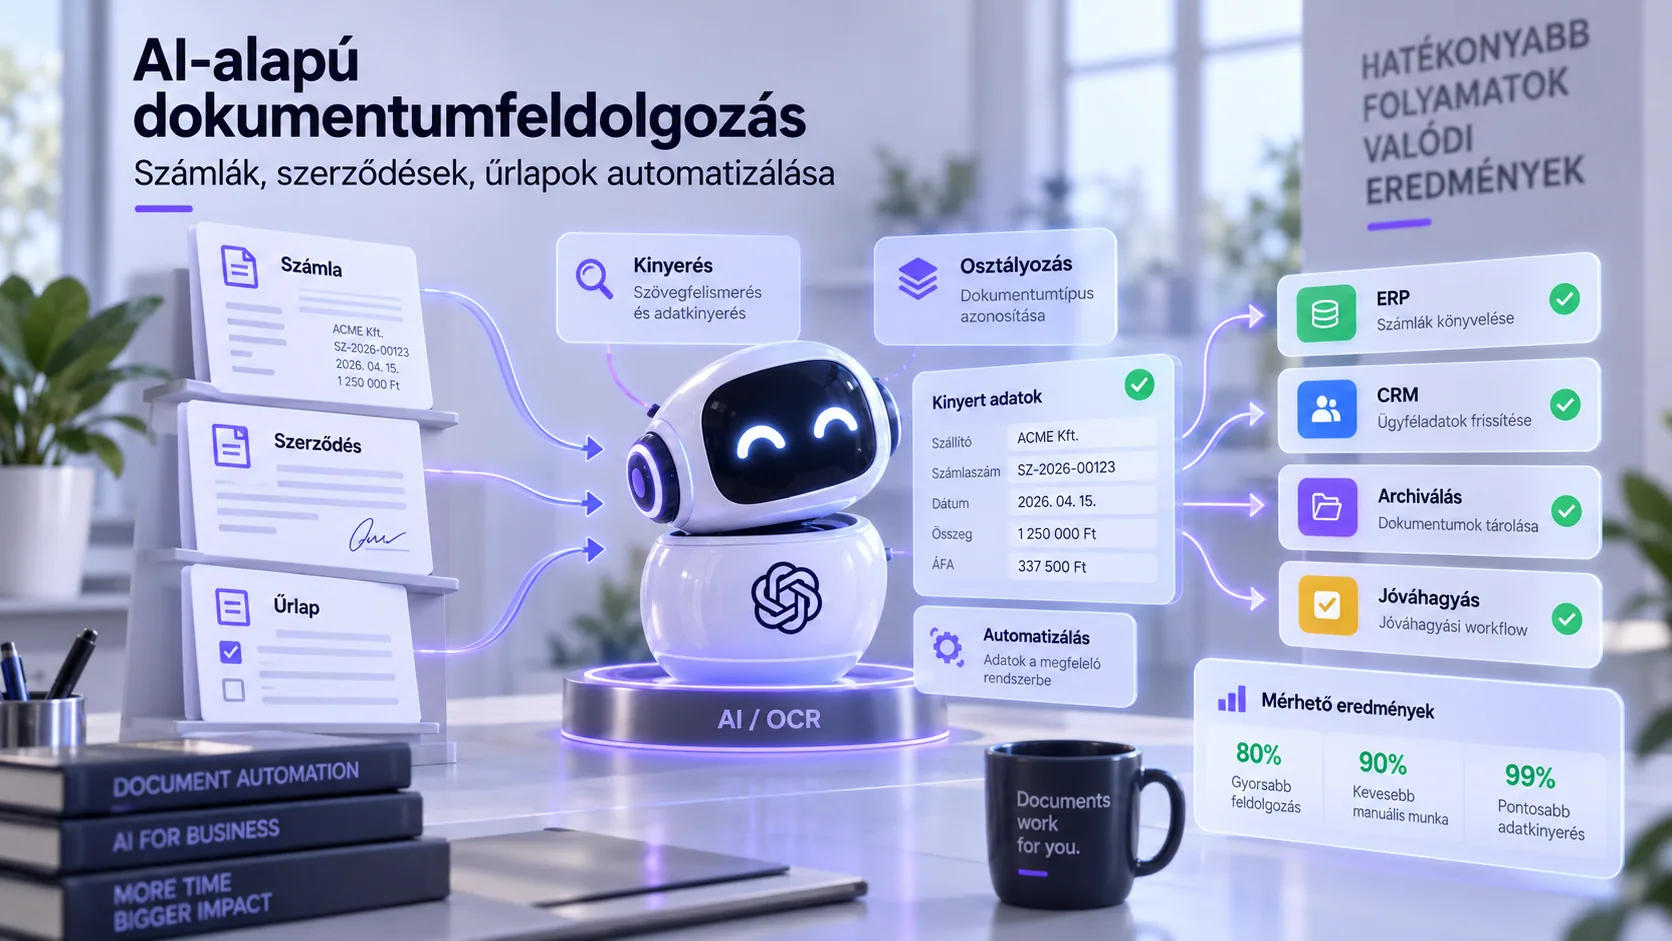
Die Dokumentenverarbeitung, der Kundenservice-Assistent und der interne RAG-Chatbot sind die drei häufigsten Fälle, in denen sich diese Frage besonders deutlich stellt; die technische Seite davon haben wir in den Artikeln KI-gestützte Dokumentenverarbeitung und Aufbau eines RAG-Chatbots beschrieben. Hier folgt die rechtliche und die schützende Ebene.
Auf welcher Rechtsgrundlage dürfen personenbezogene Daten an ein LLM gehen?
Der Einsatz eines LLM ist kein neuer Verarbeitungszweck, sondern ein neues Werkzeug für einen bestehenden Zweck. Die Rechtsgrundlage knüpft daher an den Zweck an, nicht an die Technologie. Drei typische Fälle:
| Nutzung |
Typische Rechtsgrundlage (Art. 6 DSGVO) |
Anmerkung |
| Kategorisierung von Kunden-E-Mails, Antwortentwurf |
Vertragserfüllung (b) oder berechtigtes Interesse (f) |
Die Pflege der Kundenbeziehung ist der bestehende Zweck; das LLM ist das Werkzeug |
| Extraktion von Lieferantenrechnungen |
Rechtliche Verpflichtung (c) + berechtigtes Interesse (f) |
Buchhaltungspflicht; die Daten der Kontaktperson sind Nebeninformation |
| RAG-Chatbot für interne Dokumente (auch Mitarbeiterdaten) |
Berechtigtes Interesse (f) mit Interessenabwägung |
Bei Mitarbeiterdaten ist die Praxis der Ungarischen Nationalen Behörde für Datenschutz und Informationsfreiheit (NAIH) strenger |
| Marketing-Segmentierung mit LLM |
Einwilligung (a) oder berechtigtes Interesse (f) |
Bei Profiling gelten Art. 22 und Informationspflichten |
| Vorauswahl von Lebensläufen |
Berechtigtes Interesse (f) + menschliche Entscheidung |
Wegen des Verbots automatisierter Entscheidungen (Art. 22) entscheidet ein Mensch |
Was sich mit dem LLM ändert: Es tritt ein neuer Auftragsverarbeiter hinzu (der Modellanbieter), unter Umständen findet eine neue Datenübermittlung statt (außerhalb der EU), und die Datenschutzerklärung muss aktualisiert werden, da die betroffene Person das Recht hat zu erfahren, dass ihre Daten von einem automatisierten Werkzeug verarbeitet werden. Die Rechtsgrundlage selbst ändert sich in der Regel nicht.
Zweck
Rechtsgrundlage
LLM Als Werkzeug
Neuer Verarbeiter Und Übermittlung
Hinweis: Das „berechtigte Interesse" ist kein Freifahrtschein. Dazu muss ein Interessenabwägungstest erstellt werden (siehe unten), und wenn die betroffene Person ihr eigenes Interesse für stärker hält, kann sie widersprechen. Bei Mitarbeiterdaten akzeptiert die NAIH die Einwilligung wegen des Abhängigkeitsverhältnisses nicht als Rechtsgrundlage; dort sind das berechtigte Interesse und eine ausführliche Information der gangbare Weg.
Was muss der Auftragsverarbeitungsvertrag mit dem KI-Anbieter enthalten?
Der LLM-Anbieter ist ein Auftragsverarbeiter im Sinne von Art. 28 DSGVO, sobald er personenbezogene Daten erhält. Den Vertrag (AVV, im Englischen DPA) verfassen Sie nicht selbst – der Anbieter stellt ihn als Teil seiner Geschäftsbedingungen bereit; Ihre Aufgabe ist es zu prüfen, ob alles Erforderliche enthalten ist, und ihn zu akzeptieren. 2026 enthalten die geschäftlichen API-Bedingungen aller drei großen Anbieter (Anthropic, OpenAI, Google) einen AVV.
Was Sie prüfen sollten:
| Element |
Frage |
Wo Sie es finden |
| Nutzung zu Trainingszwecken |
Ist ausgeschlossen, dass Ihr Prompt und die Antwort zum Training verwendet werden? |
Abschnitt „Training" bzw. „Model Improvement" im AVV oder in den API-Bedingungen |
| Aufbewahrungsfrist |
Wie lange speichert der Anbieter den Prompt? (typischerweise 0–30 Tage, zur Missbrauchsprüfung) |
„Data Retention" |
| Unterauftragsverarbeiter |
Wer arbeitet für den Anbieter (Cloud, Support), und wird bei Änderungen informiert? |
Liste „Subprocessors" |
| Datenübermittlung |
Bei Übermittlung in die USA: Zertifizierung nach dem EU-US Data Privacy Framework (DPF) oder Standardvertragsklauseln (SCC) |
„International Transfers" |
| Sicherheitsmaßnahmen |
Verschlüsselung, Zugriffskontrolle, Frist für die Meldung von Vorfällen |
„Security Measures", „Breach Notification" |
| Auditrecht |
Können Sie ein Zertifikat (SOC 2, ISO 27001) oder ein Audit verlangen? |
„Audit" |
| Löschung nach Vertragsende |
Was geschieht mit den Daten, wenn Sie kündigen? |
„Deletion" |
Wichtig: Die Bedingungen der Verbraucher-Chat-Oberflächen (kostenlos oder mit individuellem Abonnement) unterscheiden sich von den geschäftlichen API-Bedingungen. Bei der Verbraucheroberfläche kann die Nutzung zu Trainingszwecken die Voreinstellung sein, und es gibt keinen AVV. Für die geschäftliche Nutzung sind die API oder ein Business-Paket geeignet, und die Mitarbeiter müssen geschult werden, keine Kundendaten in ihr privates Konto zu kopieren.
Aufbewahrung und Nutzung zu Trainingszwecken: zwei getrennte Fragen
Zwei Punkte des AVV werden häufig verwechselt.
Aufbewahrung beim Anbieter. Die großen Anbieter speichern den über die API eingereichten Prompt und die Antwort zur Missbrauchsprüfung für kurze Zeit (typischerweise höchstens 30 Tage) und löschen sie danach; bei manchen Business-Paketen kann eine Aufbewahrung von null Tagen beantragt werden. Diese Frist erscheint auch in Ihrer Datenschutzerklärung als Aufbewahrungsfrist des Auftragsverarbeiters.
Nutzung zu Trainingszwecken. Die geschäftlichen API-Bedingungen schließen 2026 standardmäßig aus, dass eingereichte Daten zum Training des Modells verwendet werden. Bei Verbraucheroberflächen gilt das nicht zwangsläufig; dort sind eine entsprechende Einstellung oder ein Opt-out erforderlich. Die unternehmensinterne Regel ist einfach: Kundendaten nur über die API oder ein Business-Paket, bei dem der Ausschluss vertraglich geregelt ist.
Aufbewahrung bei Ihnen. Auch Ihre eigenen Traces (Prompt, Antwort, Ausgabe) enthalten personenbezogene Daten, sofern die Eingabe solche enthielt. Die im Artikel Prompt Engineering beschriebene Observability protokolliert deshalb pseudonymisierte oder referenzierte Eingaben, und auch der Trace hat eine Aufbewahrungsfrist (30–90 Tage), die im Verarbeitungsverzeichnis festzuhalten ist.
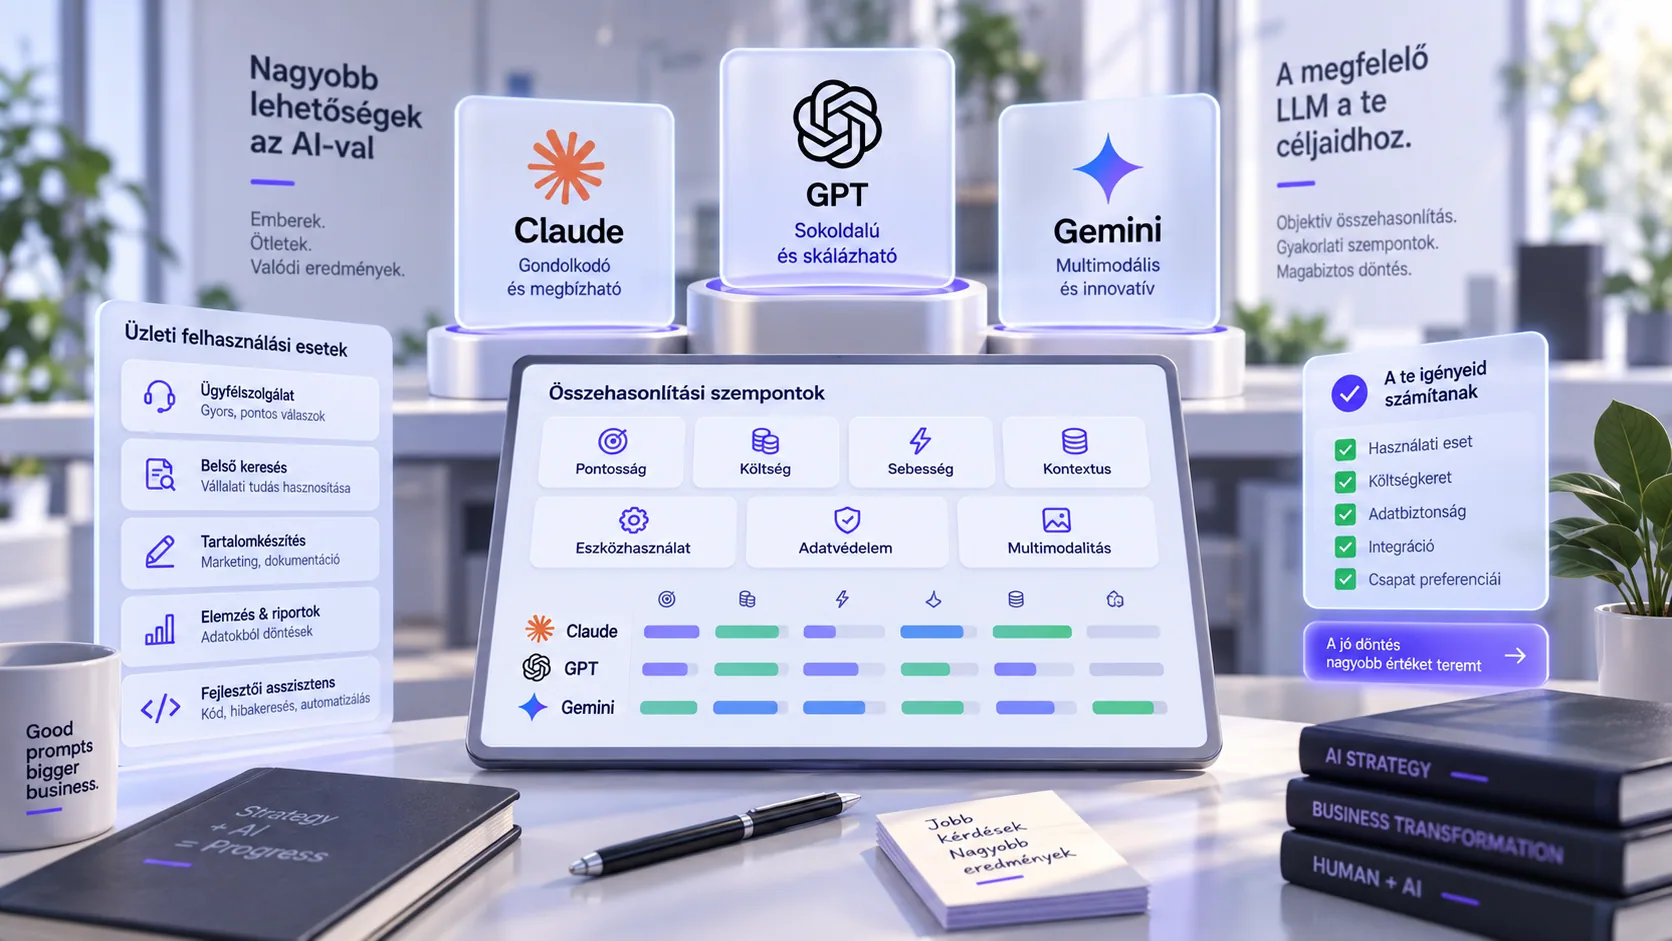
Welche Möglichkeiten der EU-Datenresidenz gibt es?
Die Datenresidenz umfasst zwei getrennte Fragen: wo die Verarbeitung läuft (auf dem Server welcher Region) und wer Zugriff hat (ein Unternehmen welcher Rechtsordnung). Die EU-regionale Verarbeitung löst die erste Frage; die zweite lösen der AVV und der Mechanismus für die Datenübermittlung.
| Anbieter |
EU-regionale Verarbeitung 2026 |
Anmerkung |
| Google (Gemini) |
Vertex AI in EU-Regionen (z. B. europe-west) |
Die Gemini-Entwickler-API ist standardmäßig nicht regionsgebunden; Vertex ist erforderlich |
| OpenAI (GPT) |
Azure OpenAI Service in EU-Regionen; eigene EU-Datenresidenz von OpenAI bei manchen Paketen |
Der Azure-Weg unterliegt dem AVV von Microsoft |
| Anthropic (Claude) |
Über Cloud-Partner (AWS Bedrock, Google Vertex AI) in EU-Regionen; bei der direkten API gemäß den jeweiligen Bedingungen |
Bei Bedrock zählt auch der AVV von AWS |
Die praktische Entscheidung: Wenn die interne Richtlinie, der Kundenvertrag oder die Branche (Gesundheitswesen, Finanzwesen, öffentlicher Sektor) eine Verarbeitung innerhalb der EU vorschreibt, sollte der Router für Aufgaben mit personenbezogenen Daten nur den EU-regionalen Pfad zulassen. Das im Artikel Modellauswahl beschriebene Router-Muster behandelt genau das mit einem sensitive-Flag.
Bleibt eine Verarbeitung außerhalb der EU bestehen (etwa weil sich die direkte API für die jeweilige Aufgabe als präziser erweist), wird eine Rechtsgrundlage für die Datenübermittlung benötigt: die Zertifizierung des Anbieters nach dem EU-US Data Privacy Framework oder Standardvertragsklauseln (SCC) im AVV, sowie der Hinweis auf die Übermittlung in der Datenschutzerklärung.
Wie bauen Sie eine Pseudonymisierungs-Pipeline?
Das geringste Risiko birgt das personenbezogene Datum, das gar nicht erst zum Modell gelangt. Die Pseudonymisierung ersetzt vor der Übermittlung die persönlichen Identifikatoren durch Platzhalter-Tokens und tauscht sie in der Antwort wieder zurück. Das Modell sieht so den Text „[PERSON_1] reklamiert wegen [BESTELLUNG_1]", was für die meisten Aufgaben ausreicht.
# Pseudonymisierung rund um den LLM-Aufruf (Python, vereinfacht)
import re
from dataclasses import dataclass, field

@dataclass
class Vault:
    """Token → Originalwert; wird nach dem Aufruf verworfen, niemals protokolliert."""
    forward: dict[str, str] = field(default_factory=dict)
    reverse: dict[str, str] = field(default_factory=dict)
    counters: dict[str, int] = field(default_factory=dict)

    def token(self, kind: str, value: str) -> str:
        if value in self.forward:
            return self.forward[value]
        self.counters[kind] = self.counters.get(kind, 0) + 1
        tok = f"[{kind}_{self.counters[kind]}]"
        self.forward[value] = tok
        self.reverse[tok] = value
        return tok

PATTERNS = {
    "EMAIL": re.compile(r"[\w.+-]+@[\w-]+\.[\w.]+"),
    "TEL": re.compile(r"(\+36|06)[ -]?\d{1,2}[ -]?\d{3}[ -]?\d{3,4}"),
    "ADOSZAM": re.compile(r"\b\d{8}-\d-\d{2}\b"),
    "IBAN": re.compile(r"\bHU\d{2}(?: ?\d{4}){6}\b"),
}

def pseudonymize(text: str, vault: Vault, ner) -> str:
    for kind, pat in PATTERNS.items():
        text = pat.sub(lambda m: vault.token(kind, m.group(0)), text)
    # Namen: per Muster nicht möglich; NER-Modell (z. B. spaCy hu) oder anhand einer Namensliste
    for name in ner.person_names(text):
        text = text.replace(name, vault.token("SZEMELY", name))
    return text

def rehydrate(text: str, vault: Vault) -> str:
    for tok, value in vault.reverse.items():
        text = text.replace(tok, value)
    return text

def run_safely(input_text: str, prompt: str, llm, ner) -> str:
    vault = Vault()
    masked = pseudonymize(input_text, vault, ner)
    answer = llm.complete(prompt, masked)          # das Modell sieht nur Tokens
    result = rehydrate(answer, vault)
    del vault                                       # der Schlüssel überlebt den Aufruf nicht
    return result
Drei Anmerkungen zum Code:
- Der Vault vergeht zusammen mit dem Aufruf. Wenn Sie ihn speichern (in einem Log, einer Datenbank), bleibt die Pseudonymisierung bei Ihnen umkehrbar, was in Ordnung ist – dann ist der Vault selbst aber ebenfalls ein personenbezogenes Datum und muss entsprechend geschützt werden.
- Die Erkennung von Namen ist der schwierige Teil. Ein regulärer Ausdruck findet E-Mail-Adresse, Telefonnummer und Steuernummer; „Kovács Péter" nicht. Erforderlich ist ein ungarisches NER-Modell (spaCy
hu_core_news oder ähnlich) oder eine aus dem eigenen Kundenstamm aufgebaute Namensliste, und die Erkennungsrate muss gemessen werden: Wie viele personenbezogene Daten bei 100 realen Texten noch enthalten geblieben sind.
- Nicht jede Aufgabe verträgt das. Wenn das Modell den Namen benötigt (etwa für die Anrede in der Antwort), wird das Token in der Antwort zurückersetzt – das funktioniert. Wenn die Aufgabe selbst die Person betrifft (Profiling), löst die Pseudonymisierung nichts; dort ist die Rechtsgrundlage die entscheidende Frage.
PII-Erkennung
Token
LLM
Rückersetzung
Löschung Des Vaults
Tipp: Zwischen Anonymisierung (nicht umkehrbar) und Pseudonymisierung (mit einem Schlüssel umkehrbar) unterscheidet die DSGVO klar: Anonyme Daten fallen aus dem Anwendungsbereich der Verordnung heraus, pseudonyme nicht. Die oben beschriebene Pipeline pseudonymisiert, weil der Vault die Rückersetzung ermöglicht. Das ist korrekt so, aber nennen Sie es in der Datenschutzerklärung nicht Anonymisierung.
Wie schreiben Sie einen Interessenabwägungstest für die LLM-Nutzung?
Ist die Rechtsgrundlage das berechtigte Interesse, erwarten die DSGVO (und die Praxis der NAIH) eine schriftliche Interessenabwägung. Der Test beantwortet drei Fragen und muss nicht länger als eine Seite sein:
| Schritt |
Frage |
LLM-spezifischer Aspekt |
| 1. Das Interesse |
Worin besteht das berechtigte Interesse des Verantwortlichen? Konkret und messbar. |
„Beantwortung von Kunden-E-Mails innerhalb von 30 Minuten statt 4 Stunden"; nicht „Effizienz" |
| 2. Erforderlichkeit |
Lässt sich der Zweck mit weniger Daten oder einem anderen Mittel erreichen? |
Ist eine Pseudonymisierung eingeführt? Gehen nur die notwendigen Felder ein? Kleineres Modell, EU-Region? |
| 3. Abwägung |
Interessen und vernünftige Erwartungen der betroffenen Person; Auswirkung; Garantien |
Neuer Auftragsverarbeiter und mögliche Übermittlung in ein Drittland; Sicherstellung des Widerspruchsrechts; menschliche Überprüfung; Information |
In der Spalte Garantien erhalten die technischen Maßnahmen (Pseudonymisierung, EU-Region, Aufbewahrungsfrist, Zugriffsprotokoll) ihren rechtlichen Wert: Jede eingeführte Schutzmaßnahme verringert die Auswirkung auf die betroffene Person und verschiebt damit die Abwägung zugunsten des Verantwortlichen. Deshalb lohnt es sich, die technische und die rechtliche Arbeit gemeinsam zu erledigen, nicht nacheinander.
Eine Datenschutz-Folgenabschätzung (DPIA) ist erforderlich, wenn die Verarbeitung voraussichtlich mit einem hohen Risiko verbunden ist: umfangreiches Profiling, besondere Kategorien personenbezogener Daten (Gesundheitsdaten, biometrische Daten) oder systematische Überwachung. Bei einer Pipeline zur Rechnungsextraktion typischerweise nicht, bei einem LLM-System, das Kundenverhalten analysiert, dagegen schon.
Was bringt der AI Act, und wann?
Die EU-KI-Verordnung (AI Act) tritt stufenweise in Kraft: die verbotenen Praktiken und die Pflicht zur KI-Kompetenz gelten ab Februar 2025, die Regeln für Allzweckmodelle ab August 2025, der Großteil der Anforderungen für Hochrisikosysteme ab August 2026, einzelne sektorspezifische Fälle bis 2027. Bei einem durchschnittlichen ungarischen KMU ist der Großteil der LLM-Nutzung (Dokumentenverarbeitung, Kundenservice-Assistent, interne Wissensdatenbank) nicht hochriskant, doch drei Dinge betreffen auch sie:
- KI-Kompetenz (Art. 4). Ein angemessenes Wissensniveau der Mitarbeiter, die das System nutzen: was es kann, was nicht, und wann ein Mensch entscheiden muss. Eine kurze interne Schulung und Dokumentation reicht aus, ist aber erforderlich.
- Transparenz (Art. 50). Wenn eine Person mit einem KI-System interagiert (Chatbot), muss sie davon wissen. Beim Kundenservice-Assistenten genügt dafür ein Satz auf der Oberfläche.
- Prüfung auf hohes Risiko. Personalwesen (Auswahl, Beförderung), Kreditwürdigkeitsprüfung, Bildungsbewertung, kritische Infrastruktur: Unterstützt das LLM eine solche Entscheidung, greifen die Pflichten nach Anhang III (Risikomanagement, menschliche Aufsicht, Protokollierung, Dokumentation). Die Vorauswahl von Lebensläufen ist der typische Fall bei einem KMU, in dem dies relevant wird.
Der AI Act und die DSGVO bestehen nebeneinander: Der AI Act regelt das Risiko des Systems, die DSGVO die Daten. Eine gut dokumentierte DSGVO-Konformität (Datenlandkarte, Rechtsgrundlage, Garantien, Protokoll) deckt auch einen Großteil des Dokumentationsbedarfs des AI Act ab.
Praktische Checkliste vor dem Start eines LLM-Projekts
Zwölf Punkte, in dieser Reihenfolge. Lautet die Antwort bei einem Punkt „Nein", halten Sie dort inne, bevor Sie live gehen.
- Datenlandkarte: welche personenbezogenen Daten an das Modell gehen, von wem, woher, zu welchem Zweck.
- Datenminimierung: nicht erforderliche Felder werden nicht übermittelt; Pseudonymisierung, wo die Aufgabe es zulässt.
- Rechtsgrundlage je Zweck, schriftlich; bei berechtigtem Interesse ein Interessenabwägungstest.
- AVV mit dem KI-Anbieter: Ausschluss der Nutzung zu Trainingszwecken, Aufbewahrung, Unterauftragsverarbeiter, Übermittlung, Löschung.
- Nur API oder Business-Paket; Verbot von Verbraucherkonten für geschäftliche Daten, mit interner Richtlinie.
- Entscheidung zur Datenresidenz: EU-Region, wenn die Richtlinie, die Branche oder der Kunde dies verlangt; Router für
sensitive-Aufgaben.
- Rechtsgrundlage der Datenübermittlung, falls eine Verarbeitung außerhalb der EU bestehen bleibt (DPF-Zertifizierung oder SCC).
- Eigene Aufbewahrung: Traces pseudonymisiert, mit Aufbewahrungsfrist und Zugriffsprotokoll.
- Aktualisierung der Datenschutzerklärung: neuer Auftragsverarbeiter, automatisiertes Werkzeug, Übermittlung, Aufbewahrung, Widerspruchsrecht.
- Aktualisierung des Verarbeitungsverzeichnisses (Art. 30) um den neuen Verarbeiter und Zweck.
- Prüfung des DPIA-Bedarfs; Ausschluss oder Behandlung eines hochriskanten AI-Act-Falls.
- Menschliche Überprüfung und KI-Kompetenz: wer entscheidet, wer kontrolliert, wer wurde geschult.
Unsere auf der Über-uns-Seite beschriebenen Grundsätze der Datenverarbeitung (wir arbeiten in der Umgebung des Auftraggebers, bewahren weder Code noch Daten auf) bilden die Lieferantenseite dieser Liste: Auch der Entwicklungspartner ist ein Auftragsverarbeiter, und dieselben Fragen gelten auch für ihn.
Häufig gestellte Fragen
Darf ich Kundendaten an ChatGPT, Claude oder Gemini weitergeben?
Ja, sofern Sie die API oder ein Business-Paket mit einem AVV inklusive Ausschluss der Nutzung zu Trainingszwecken verwenden, die Rechtsgrundlage für den Zweck vorliegt und Ihre Datenschutzerklärung den neuen Auftragsverarbeiter nennt. Über ein Verbraucherkonto (kostenlose oder individuelle Chat-Oberfläche) nicht: Dort gibt es keinen AVV, und die Nutzung zu Trainingszwecken kann die Voreinstellung sein.
Reicht es, die Daten vor dem LLM zu anonymisieren?
Ist die Ersetzung umkehrbar (mit einem Schlüssel, einem Vault), handelt es sich um eine Pseudonymisierung, und die Daten bleiben personenbezogen: Die DSGVO gilt weiterhin, aber das Risiko und die Interessenabwägung verbessern sich erheblich. Eine echte Anonymisierung (nicht umkehrbar) nimmt die Daten aus dem Anwendungsbereich der DSGVO heraus, ist aber bei den meisten geschäftlichen Aufgaben nicht möglich, weil die Antwort wieder mit der Person verknüpft werden muss.
Ist für einen LLM-basierten Kundenservice-Assistenten eine DPIA erforderlich?
Typischerweise nicht, wenn der Assistent nur einen Antwortentwurf erstellt, den ein Mensch versendet, kein Profiling stattfindet und die Daten pseudonymisiert oder minimiert an das Modell gehen. Erforderlich ist sie, wenn das LLM Kundenverhalten analysiert, eine automatisierte Entscheidung trifft (etwa Rabatt, Ablehnung) oder besondere Kategorien personenbezogener Daten (Gesundheitsdaten) verarbeitet.
Gilt der AI Act für die LLM-Nutzung eines ungarischen KMU?
Ja, aber in den meisten Fällen nur die Pflichten zur KI-Kompetenz und zur Transparenz: die Schulung der Mitarbeiter und der Hinweis darauf, wenn jemand mit einem KI-System spricht. Die Anforderungen für Hochrisikosysteme greifen, wenn das LLM eine HR-Entscheidung, eine Kreditwürdigkeitsprüfung oder eine ähnliche, in Anhang III aufgeführte Entscheidung unterstützt.
Fazit
Die DSGVO-Seite der LLM-Nutzung ist 2026 weder ein Verbot noch eine Grauzone: Es tritt ein neuer Auftragsverarbeiter hinzu, unter Umständen eine Datenübermittlung, und der dazugehörige Papierkram, den die meisten Unternehmen bei der Einführung eines Cloud-CRM oder einer Lohnbuchhaltungssoftware bereits einmal durchlaufen haben. Der Unterschied liegt in den technischen Garantien: Pseudonymisierung, EU-Region, Aufbewahrungsfrist, Berechtigungen und Protokoll, die auch die rechtliche Abwägung zugunsten des Unternehmens verschieben.
Die von uns empfohlene Reihenfolge: Datenlandkarte und Minimierung (ein Tag), AVV-Prüfung und Entscheidung zur Datenresidenz (ein Tag), Pseudonymisierungs-Pipeline und Trace-Regeln (zwei bis drei Tage), Rechtsgrundlage, Interessenabwägung und Datenschutzerklärung gemeinsam mit dem Datenschutzbeauftragten oder der Rechtsabteilung (eine Woche Durchlaufzeit). Das sind insgesamt zwei Wochen, parallel zur technischen Entwicklung, nicht im Anschluss daran.
Der AI Act bringt im Vergleich dazu bei einem typischen KMU wenig Neues: Schulung, Transparenz und die Prüfung, dass das System keine HR- oder Kreditentscheidung trifft. Wer die DSGVO-Seite ordentlich dokumentiert hat, verfügt bereits über den Großteil der AI-Act-Dokumentation.
Offizielle Quellen
- DSGVO — Verordnungstext (EUR-Lex): Art. 6 Rechtsgrundlagen, Art. 28 Auftragsverarbeiter, Art. 30 Verzeichnis, Art. 35 DPIA
- NAIH — Ungarische Nationale Behörde für Datenschutz und Informationsfreiheit: ungarische Behördenpraxis, Stellungnahmen, Leitfaden zur Interessenabwägung
- EDPB — Europäischer Datenschutzausschuss: Leitlinien, darunter die Stellungnahme vom Dezember 2024 zu KI-Modellen
- AI Act — Verordnungstext (EUR-Lex): Art. 4 KI-Kompetenz, Art. 50 Transparenz, Anhang III Hochrisiko
- Anthropic — Privacy Center: API-Datenverarbeitung, Aufbewahrung, AVV
- OpenAI — Enterprise Privacy: Datenverarbeitung bei API und Business-Paketen
Verwandte Artikel von uns: DSGVO-Konformität für Mobil-Apps, KI-gestützte Dokumentenverarbeitung, Claude vs. GPT vs. Gemini für den geschäftlichen Einsatz.
Wenn Sie ein LLM-Projekt starten möchten und sich fragen, was an das Modell gehen darf und unter welchen Bedingungen, vereinbaren Sie ein 30-minütiges Gespräch: Wir gehen gemeinsam die Datenlandkarte, die Anbieterbedingungen und die Möglichkeiten der Pseudonymisierung durch und legen zusammen mit Ihrem Datenschutzbeauftragten fest, was für einen rechtskonformen Start nötig ist. In unseren Projekten zur KI-Automatisierung ist das Teil der Discovery-Phase, keine nachträgliche Korrektur.