LLMs halluzinieren – das ist kein Fehler, sondern liegt in der Natur generativer Modelle. Autoregressive Modelle treffen jede Token-Entscheidung auf Basis einer Wahrscheinlichkeitsverteilung, und nichts stellt sicher, dass die gewählte Fortsetzung faktisch korrekt ist. Ein produktives KI-System darf nicht versprechen, dass es keine Halluzinationen gibt (das kann niemand zusichern) – es muss vielmehr sicherstellen, dass die Halluzinationsrate messbar und auf einem akzeptablen Niveau bleibt.
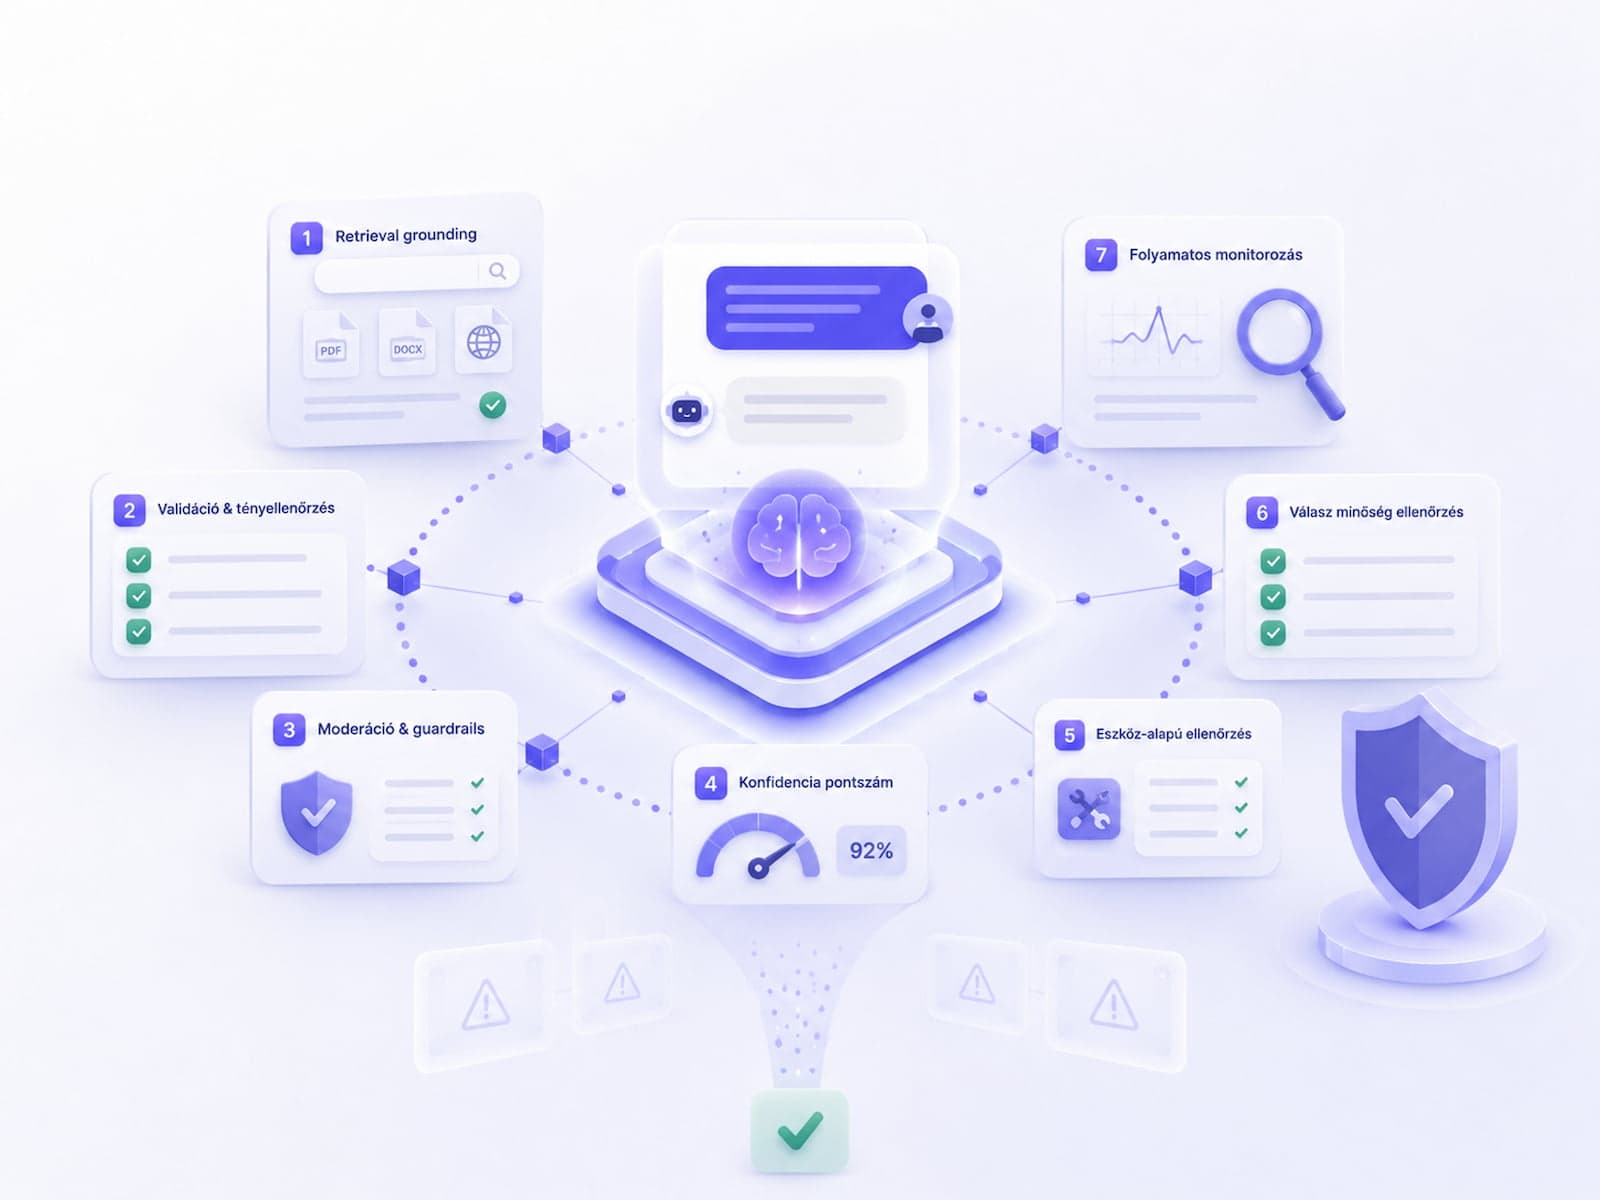
In diesem Artikel stelle ich sieben bewährte Abwehrmaßnahmen vor, die zusammen die Baseline-Genauigkeit von 60-70 % auf 92-95 % in den meisten Domänen anheben. Die Techniken bauen aufeinander auf – sie sind keine Alternativen, sondern Ergänzungen zueinander.
Was ist eine Halluzination und wo tritt sie auf
„Halluzination" ist ein Sammelbegriff – er umfasst drei unterschiedliche Phänomene:
- Faktische Halluzination: Das Modell behauptet eine Tatsache, die nicht zutrifft. Beispiel: „Der Q4-Abwanderungsschwellenwert im Liefer-SLA 2024 liegt bei 8 %" – obwohl im Dokument 12 % steht.
- Quellen-Halluzination: Das Modell beruft sich auf eine Quelle, die nicht existiert. Beispiel: „Gemäß Ziffer 4.2.1 der Richtlinie …" – obwohl es keine Ziffer 4.2.1 gibt.
- Schlussfolgerungs-Halluzination: Das Modell zieht aus korrekten Daten eine falsche Schlussfolgerung. Beispiel: „Da das Urlaubskontingent 25 Tage beträgt und X bereits 24 Tage verbraucht hat, steht ihm diese Woche kein Urlaub mehr zu" – dabei sieht die Richtlinie 30 Tage vor.
Die drei Fälle erfordern jeweils andere Abwehrmaßnahmen: Faktische Halluzinationen werden durch RAG und Zitation adressiert, Quellen-Halluzinationen durch Schema-Validierung und Quellenprüfung, Schlussfolgerungs-Halluzinationen durch Self-Consistency und Human-in-the-Loop.
Wo sie im produktiven Betrieb auftritt
Unserer Erfahrung nach tritt die Halluzination am häufigsten in den folgenden vier Situationen auf:
- Out-of-Domain-Anfrage – der Nutzer stellt eine Frage, zu der es in der Vector-DB keine Quelle gibt. Das Modell „füllt die Lücke" mit einer erfundenen Antwort.
- Teilweise Quelle – der Quell-Chunk enthält die Antwort nur teilweise, und das Modell extrapoliert.
- Widersprüchliche Quellen – zwei Chunks liefern unterschiedliche Informationen, das Modell wählt eine davon aus oder vermischt sie.
- Long-Tail-Edge-Case – eine ungewöhnliche, seltene Frage, die von den Trainingsdaten kaum abgedeckt wurde.
Die sieben Abwehrmaßnahmen sind genau auf diese vier Szenarien ausgelegt.
1. Context Grounding (RAG)
Die wirksamste Technik: Lassen Sie das LLM nicht frei generieren – geben Sie ihm immer Kontext. Das Prinzip von Retrieval-Augmented Generation besteht darin, die aus der Vector-DB abgerufenen relevanten Dokumente im System-Prompt zu übergeben und explizit anzuweisen: „Antworte nur aus den Quellen".
Das Grundmuster
system_prompt = """
You are a documentation assistant.
ONLY answer based on the SOURCES below.
If the sources don't contain the answer, say "I don't know".

SOURCES:
[1] {source_1}
[2] {source_2}
[3] {source_3}

Question: {user_query}
"""
Die Anweisung „nur aus den Quellen" ist allein noch keine Zusicherung – aber sie hebt die Präzision gegenüber der Baseline um 20-30 Punkte an. Die detaillierte Implementierung der RAG-Pipeline: Aufbau eines RAG-Chatbots.
Negative Prompt-Anweisungen
Die Antwort „Ich weiß es nicht" muss als explizit erlaubte Ausgabe definiert sein. LLMs neigen standardmäßig dazu, „hilfsbereit sein zu wollen", was sie dazu verleitet, auf jede Frage eine Antwort zu geben. Dieses Verhalten muss aktiv überschrieben werden:
"""
IMPORTANT:
- If the sources don't contain the answer, output EXACTLY: "Ich konnte in den Dokumenten keine eindeutige Antwort finden."
- Do NOT speculate or guess.
- Do NOT use general knowledge from your training data.
- Do NOT combine information from sources unless they explicitly support each other.
"""
Diese Anti-Instruktionen senken die Rate faktischer Halluzinationen um 15-20 Prozentpunkte.
Source Attribution Required
Im System-Prompt wird explizit gefordert, dass jede Antwort mindestens eine Quelle referenziert. Ohne Quelle ist die Antwort nicht zulässig.
Messbare Wirkung
| Setup |
Faktische Genauigkeit (Eval-Set) |
| Nur LLM (ohne RAG) |
45-55 % |
| RAG mit naivem Prompt |
70-78 % |
| RAG mit Grounding-Anweisungen |
85-92 % |
2. Citation Requirement
Verlangen Sie vom LLM nicht nur eine Antwort, sondern auch eine Quellenkennung. Das bringt zwei Vorteile: (1) Das LLM erfindet seltener eine Antwort, weil es weiß, dass es einen Quellenverweis liefern muss, (2) der Nutzer kann die Antwort überprüfen.
Implementierung
system_prompt = """
For EVERY factual claim in your answer, cite the source ID in square brackets, e.g. [1].
If you cannot cite a source for a claim, do not make the claim.
If a sentence has no citation, you are not allowed to write it.

Format example:
"Das Urlaubskontingent beträgt 25 Tage [2]. Es wird jedes Jahr zum 1. Januar neu gewährt [2, 5]."
"""
Post-Processing-Validierung
import re

def validate_citations(response: str) -> dict:
    sentences = re.split(r"(?<=[.!?])\s+", response.strip())
    factual_sentences = [s for s in sentences if not is_intro_or_summary(s)]

    no_citation = [
        s for s in factual_sentences
        if not re.search(r"\[\d+(?:,\s*\d+)*\]", s)
    ]

    return {
        "total_sentences": len(factual_sentences),
        "uncited_sentences": no_citation,
        "passes": len(no_citation) == 0,
    }
Gibt es uncited_sentences, passiert die Antwort das Quality Gate nicht. Es folgt entweder eine erneute Generierung oder ein Human-Handoff.
Messung der Zitationshäufigkeit
In einem gut abgestimmten System tragen 80-90 % der Sätze eine Zitation. Liegt dieser Wert unter 50 %, ignoriert das Modell die Anweisung – der Prompt muss nachgeschärft werden.
Tipp: Ein Nebeneffekt der Zitationspflicht sind kompaktere Antworten. LLMs neigen dazu, lange, „expertenhaft klingende" Erklärungen zu generieren – 60-70 % davon bleiben ohne Zitation. Die Zitationspflicht kürzt die Antworten automatisch auf die belegbaren Teile.
3. Temperature- und Top-p-Tuning
Die Parameter temperature und top_p bestimmen die „Kreativität" des Modells. Hoher Wert = mehr Variabilität = höheres Halluzinationsrisiko. Niedriger Wert = deterministischer = weniger Halluzination.
Die beiden Parameter
temperature (0.0-2.0): die Flachheit der Logit-Verteilung. 0 = immer das Top-1-Token, 2 = nahezu gleichverteilt.top_p (0.0-1.0): der kumulative Wahrscheinlichkeits-Cutoff. 0,1 = die Auswahl erfolgt nur aus den Tokens mit den obersten 10 % Wahrscheinlichkeit.
Stellen Sie jeweils nur einen der beiden Parameter ein (den anderen auf dem Standardwert belassen). Das empfiehlt auch die OpenAI-Dokumentation.
Empfehlung je Use Case
| Use Case |
Empfohlene Temperature |
Empfohlener top_p |
| RAG Faktenfragen (Q&A) |
0.0-0.2 |
0.1-0.3 |
| Dokumentenzusammenfassung |
0.1-0.3 |
0.2-0.4 |
| Tutorial / Erklärung |
0.2-0.4 |
0.3-0.5 |
| Marketing-Texte |
0.5-0.7 |
0.6-0.8 |
| Brainstorming, divergent |
0.7-1.0 |
0.8-0.95 |
| Codegenerierung |
0.0-0.2 |
0.1-0.3 |
Anmerkung zu temperature=0
temperature=0 stellt keinen deterministischen Output sicher – der Token-Tie-Break kann stochastisch bleiben, und LLM-Anbieter erreichen nicht immer vollständigen Determinismus. Der seed-Parameter (von OpenAI unterstützt) hilft, aber nicht zu 100 %.
Codebeispiel
response = openai.chat.completions.create(
    model="gpt-4o",
    messages=[...],
    temperature=0.1,
    seed=42,  # für Reproduzierbarkeit
    max_tokens=500,
)
4. Self-Consistency Checking
Führen Sie bei kritischen Antworten die Generierung mit drei unterschiedlichen Seeds durch (temperature=0.3, drei verschiedene Zufalls-Seeds). Sagen alle drei dasselbe aus, besteht hohe Konfidenz. Gibt es Abweichungen, wird dies dem Nutzer angezeigt oder ein Human-in-the-Loop-Fallback ausgelöst.
Implementierung
def self_consistency_check(prompt: str, seeds: list[int] = [42, 100, 7]) -> dict:
    responses = []
    for seed in seeds:
        response = llm.generate(
            prompt,
            temperature=0.3,
            seed=seed,
            max_tokens=500,
        )
        responses.append(response)

    return {
        "responses": responses,
        "consistent": all_semantically_equivalent(responses),
        "majority_vote": majority(responses),
    }
all_semantically_equivalent lässt sich mit einem zweiten LLM-Aufruf messen (einem „Judge"-LLM, das prüft, ob die drei Antworten inhaltlich dasselbe aussagen), oder mit einfachem Substring-Overlap (ROUGE-L-Score > 0.85).
Kosten und Einsatzkriterien
Das bedeutet dreimal so viele API-Aufrufe wie eine einfache Single-Generation. Nur für kritische Entscheidungen einsetzen (medizinisch, juristisch, finanziell). Bei einem einfachen FAQ-Chatbot ist das Overkill.
Aggregationsstrategie
Weichen die drei Antworten voneinander ab:
- Majority Vote: Sind zwei Antworten identisch und eine abweichend → die Mehrheitsantwort gilt.
- Hedge: Weichen alle drei voneinander ab → „Für diese Frage gibt es mehrere mögliche Interpretationen. [Quellenangabe für alle drei Fälle]."
- Escalate: In kritischem Kontext erfolgt sofort ein Human-Handoff.
5. Output-Validierung (JSON Schema, Regex)
Gibt das LLM strukturierte Daten aus (Kategorie, Score, JSON-Objekt), validieren Sie diese gegen ein Schema. OpenAIs JSON-Modus und Anthropic Tool Use erzwingen ein Schema bereits auf API-Ebene, dennoch bleibt eine Post-Validierung erforderlich.
Pydantic + OpenAI
from pydantic import BaseModel, Field
from typing import Literal
import openai

class LeadClassification(BaseModel):
    category: Literal["technical", "commercial", "complaint", "partnership"]
    urgency: int = Field(ge=0, le=100)
    confidence: float = Field(ge=0.0, le=1.0)
    follow_up_draft: str = Field(max_length=500)
    reasoning: str = Field(max_length=200)

response = openai.chat.completions.create(
    model="gpt-4o",
    messages=[...],
    response_format={"type": "json_object"},
    temperature=0.1,
)

try:
    result = LeadClassification.model_validate_json(
        response.choices[0].message.content
    )
except ValidationError as e:
    # Retry, Fallback oder manuelle Warteschlange
    handle_invalid_output(e)
Structured Output (OpenAI 2024+)
OpenAI hat 2024 zusätzlich zu response_format das Feature Structured Outputs eingeführt. Die verpflichtende Einhaltung des Schemas wird dabei auf Provider-Ebene sichergestellt:
response = openai.chat.completions.create(
    model="gpt-4o-2024-08-06",
    messages=[...],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "lead_classification",
            "schema": LeadClassification.model_json_schema(),
            "strict": True,
        },
    },
)
Mit strict: True lässt sich eine Schema-Verletzung praktisch ausschließen.
Retry-Strategie
Schlägt die Validierung fehl, wird maximal zweimal erneut versucht. Beim zweiten Retry wird der vorherige Fehler explizit im System-Prompt vermerkt:
def call_with_retry(prompt, schema, max_retries=2):
    for attempt in range(max_retries + 1):
        response = llm.generate(prompt)
        try:
            return schema.model_validate_json(response)
        except ValidationError as e:
            if attempt < max_retries:
                prompt = augment_prompt_with_error(prompt, e)
            else:
                return fallback_default()
Messbare Wirkung
Ohne Schema-Validierung liegt die Rate fehlerhaften JSONs im produktiven Betrieb bei 3-8 %. Mit Schema-Validierung sinkt sie auf unter 0,5 %.
6. Confidence Scoring + Schwellenwert
Bitten Sie das LLM, für die eigene Antwort einen Confidence Score anzugeben. Das funktioniert nicht immer zuverlässig (LLMs neigen zu Overconfidence), zeigt aber häufig trotzdem Edge Cases an.
System-Prompt
After your answer, output a confidence score on a scale of 0-100:
- 90-100: Sources clearly and completely support the answer
- 70-89: Sources support, but some inference needed
- 50-69: Partial support, some details missing
- 30-49: Weak support, significant gaps
- <30: Insufficient sources, answer is uncertain

Output format:
ANSWER: [your answer with citations]
CONFIDENCE: [0-100]
REASONING: [why this confidence level]
Threshold-basiertes Routing
def route_by_confidence(response: dict) -> str:
    if response["confidence"] >= 80:
        return "auto_send"
    elif response["confidence"] >= 50:
        return "auto_send_with_flag"  # "Bitte prüfen:"
    elif response["confidence"] >= 30:
        return "human_review_queue"
    else:
        return "explicit_not_found"
Das vierstufige Routing hat sich in der Praxis am besten bewährt. Die „Flag"-Variante ist besonders für Marketing-Texte nützlich – bei 60 % Confidence liegt das LLM oft richtig, ist sich nur nicht ganz sicher.
Kalibrierungsprüfung
Bei 80-90 % Confidence erreichen LLMs häufig nur 60-70 % Accuracy – sie sind overconfident. Das muss manuell kalibriert werden. Typische Abstimmung:
| Modell-Confidence |
Tatsächliche Accuracy |
Use Case |
| 90-100 |
88-95 % |
Auto-Send |
| 70-89 |
75-85 % |
Auto-Send (mit Kennzeichnung) |
| 50-69 |
55-70 % |
Manuelle Überprüfung |
| 30-49 |
30-50 % |
Explizit „nicht gefunden" |
| <30 |
<30 % |
Explizit „nicht gefunden" |
Das lässt sich anhand des Eval-Sets messen, und die Schwellenwerte müssen entsprechend angepasst werden.
Tipp: Der Confidence Score ersetzt nicht das Eval-Set. Ein Modell kann 95 % Confidence angeben, während die tatsächliche Accuracy bei 70 % liegt. Die beiden Kennzahlen müssen getrennt getrackt werden.
7. Human-in-the-Loop-Fallback
Auch die sechs vorangegangenen Techniken erreichen keine 100 %. Planen Sie einen flexiblen Eskalationspfad:
Das vierstufige Modell
┌─────────────────────────────────────────────────────────┐
│ High confidence + citation + schema valid                │
│   → Auto-response                                         │
├─────────────────────────────────────────────────────────┤
│ Medium confidence (50-70) + valid                         │
│   → Auto-response, Flag "Bitte prüfen"                    │
├─────────────────────────────────────────────────────────┤
│ Low confidence (<50) OR uncited sentences                 │
│   → Human review queue                                    │
├─────────────────────────────────────────────────────────┤
│ No sources found OR validation fails 2x                   │
│   → Explizit "keine Information gefunden" + Ticket-Erstellung │
└─────────────────────────────────────────────────────────┘
Implementierung
def handle_query(query: str) -> dict:
    response = generate_with_rag(query)

    if not response["citations"]:
        return {"action": "queue", "reason": "no_citations"}
    if not response["schema_valid"]:
        return {"action": "queue", "reason": "invalid_schema"}
    if response["confidence"] < 50:
        return {"action": "queue", "reason": "low_confidence"}
    if response["confidence"] < 70:
        return {"action": "auto_with_flag", "flag": "verify_recommended"}
    return {"action": "auto", "response": response["text"]}
Warteschlangen-Management
Die typische Größe der Human-Review-Warteschlange liegt bei 5-15 % des Gesamtaufkommens. Das interne Team des Kunden (Vertrieb, Support) prüft schnell (im Schnitt 30-60 Sekunden pro Fall), und die Erkenntnisse fließen in die Erweiterung des Eval-Sets ein.
Feedback-Loop
Im Human-Review abgelehnte bzw. korrigierte Antworten fließen an zwei Stellen ein:
- Erweiterung des Eval-Sets: Der Fall gilt nun als bekannter „schwieriger" Fall.
- Prompt-Feinabstimmung: Bei 5 oder mehr Fehlern desselben Typs wird die Ausnahme direkt in den System-Prompt eingebaut.
Das Eval-Set — der Schlüssel zu allem
Die sieben Techniken lassen sich nur mit einem Eval-Set messen. Mindestens 50-200 manuell gelabelte Input-Output-Paare, ausgewogen über die Verteilung der Use Cases.
Minimalstruktur
eval_dataset = [
    {
        "id": "eval_001",
        "query": "Was besagt das Liefer-SLA 2024 zur Q4-Abwanderung?",
        "expected_keywords": ["Q4", "Abwanderung", "12%"],
        "expected_citation": ["doc_42_chunk_3"],
        "category": "factual_extraction",
        "difficulty": "easy",
    },
    {
        "id": "eval_002",
        "query": "Wann wurde das Liefer-SLA geändert?",
        "expected_keywords": ["keine eindeutige Antwort"],  # Negativfall
        "expected_citation": [],
        "category": "out_of_domain",
        "difficulty": "medium",
    },
    # ...
]
Metriken
| Metrik |
Definition |
Ziel |
| Faithfulness |
Stützt sich die Antwort ausschließlich auf die Quellen? |
95 %+ |
| Answer Relevancy |
Bezieht sich die Antwort auf die gestellte Frage? |
90 %+ |
| Context Precision |
Sind die abgerufenen Chunks relevant? |
80 %+ |
| Citation Accuracy |
Verweisen die Zitationen auf reale Quellen? |
99 %+ |
| Schema Validity |
Ist der JSON-Output schema-konform? |
99 %+ |
| Confidence Calibration |
Korrelation zwischen Confidence und Accuracy |
±10 % |
Das Ragas-Framework berechnet diese Metriken automatisiert.
Pflege
Die Pflege des Eval-Sets ist eine tägliche Aufgabe:
- Neue Edge Cases → ins Eval-Set (während der Hyper-Care-Phase sind 5-10 neue Fälle pro Woche üblich).
- Negatives Nutzerfeedback → ins Eval-Set — eine Meldung „falsche Antwort" ist immer ein Ausgangspunkt.
- Prompt-Änderungen → Regressionstest gegen das Eval-Set. Liegt die Genauigkeit unter dem Schwellenwert → wird das Deployment blockiert.
In der CI/CD-Pipeline:
# .github/workflows/eval.yml
on:
  pull_request:
    paths:
      - "prompts/**"
      - "src/llm/**"
jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Eval-Suite ausführen
        run: python eval/run.py --threshold 0.92
      - name: Bei Fehlschlag abbrechen
        if: failure()
        run: exit 1
Mess-Framework — Ragas und Co.
Die 2025-2026 ausgereiften Open-Source-Eval-Frameworks:
- Ragas: RAG-spezifische Metriken. Python-basiert, aufgebaut auf der OpenAI-/Anthropic-API. Die Standardwahl.
- DeepEval: Ein Pytest-ähnliches Assertion-Framework für LLM-Output. Gut für die CI-Integration geeignet.
- promptfoo: Ein Web-UI-basiertes Tool zum Prompt-Vergleich. Gut geeignet für die manuelle Tuning-Phase.
- OpenAI Evals: OpenAIs eigenes Framework, etwas schwerfälliger in der Handhabung.
In Corevanix-Projekten setzen wir auf die Kombination Ragas + DeepEval: Ragas für die Qualitätsmetriken, DeepEval für die CI-blockierenden Assertions.
Zusammenfassung — die sieben Techniken kombiniert
Die sieben Techniken ersetzen einander nicht – sie wirken zusammen. In einem produktionsreifen System typischerweise:
| Technik |
Kostenwirkung |
Genauigkeitswirkung |
Verpflichtend? |
| 1. Context Grounding (RAG) |
$$$ |
+25-30 pp |
Verpflichtend |
| 2. Citation Requirement |
$ |
+5-8 pp |
Verpflichtend |
| 3. Temperature-Tuning |
$0 |
+3-5 pp |
Verpflichtend |
| 4. Self-Consistency |
$$$$ |
+5-10 pp |
Nur bei kritischen Fällen |
| 5. Schema-Validierung |
$ |
+2-3 pp |
Verpflichtend bei strukturiertem Output |
| 6. Confidence Scoring |
$ |
+5-8 pp (bei aktivem Routing) |
Dringend empfohlen |
| 7. Human-in-the-Loop |
n/a |
+10-15 pp (effektiv) |
In den ersten Monaten verpflichtend |
Der vollständige Stack bringt eine Verbesserung von +60-70 pp gegenüber der Baseline. Das entspricht häufig dem Sprung von „45 % Accuracy → 92 %+ Accuracy".